TP・FP・FN・TNの違いとは?混同行列の覚え方と計算式を徹底解説
機械学習モデルの性能評価や医療検査の精度検証において、避けて通れないのが「混同行列(Confusion Matrix)」の理解です。しかし、いざ実務や学習で「TP・FP・FN・TNのどれがどれだかわからなくなる」「適合率と再現率の計算式が頭に入らない」という壁にぶつかる人は後を絶ちません。
AI導入が進む開発現場やデータ分析の実務では、これらの評価指標の取り違えが「致命的な見逃し」や「不要なアラート多発」といった甚大なトラブルに直結します。本稿では、混同行列の基本構造から、絶対に忘れない直感的な覚え方、適合率・再現率・F値の計算式、さらには実務における指標の選び方まで、専門記者の視点で体系的に解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:TP・FP・FN・TNは「2文字目(モデルの予測)」→「1文字目(その予測の正否)」の順で読むと一瞬で判別できる。
- 要点2:不均衡データでは「正解率(Accuracy)」が役に立たないため、目的(見逃し防止か誤報防止か)に応じて「適合率」「再現率」「F値」を使い分ける必要がある。
- 要点3:偽陽性(第一種の過誤)と偽陰性(第二種の過誤)の事業リスクを天秤にかけ、ROC曲線・AUCやPR曲線を駆使した閾値設定が実務の成否を分ける。
混同行列のTP・FP・FN・TNはどっち?絶対に間違えない直感的な覚え方
混同行列(Confusion Matrix)を前にした際、最も多くの初学者が混乱するのが「TP(True Positive)」「FP(False Positive)」「FN(False Negative)」「TN(True Negative)」の4要素の割り当てです。日本語訳である「真陽性」「偽陽性」「偽陰性」「真陰性」という漢字表記も、パッと見ただけでは直感的に捉えにくい要因となっています。
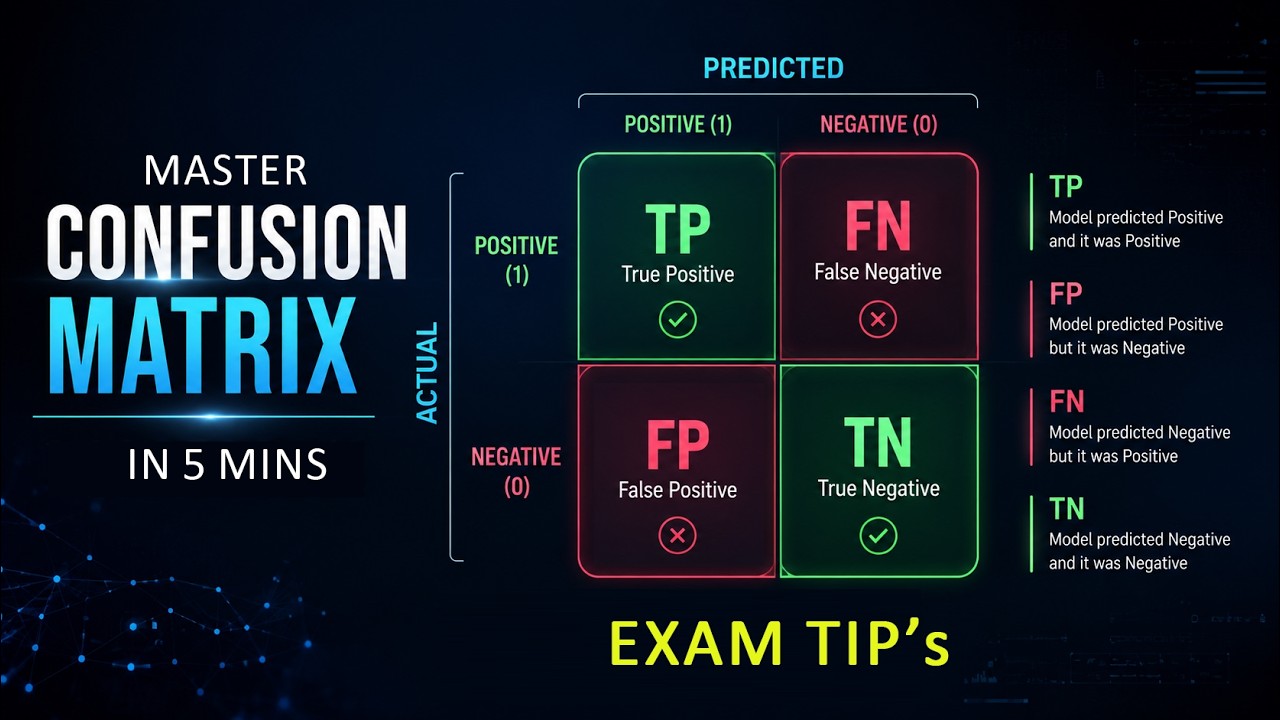
この混乱を完全に解消するルールが、「2文字目(モデルの予測結果)を見てから、1文字目(その予測が合っていたか)を判定する」というアプローチです。
英語の2文字表記は、後ろから前に向かって読む構造になっています。
具体的には、以下の順序で思考をトレースします。
1. 2文字目(PまたはN):モデルはなんと判定したか?
・Positive(P)= モデルは「陽性(異常・該当あり)」と判定した
・Negative(N)= モデルは「陰性(正常・該当なし)」と判定した
2. 1文字目(TまたはF):モデルの判定は正解だったか?
・True(T)= 判定は「正しかった(正解)」
・False(F)= 判定は「間違っていた(不正解)」
このルールを4つの要素に当てはめると、次のように明確化されます。
・TP(True Positive / 真陽性):モデルが「陽性(P)」と予測し、それが「正しかった(T)」= 実際も陽性
・FP(False Positive / 偽陽性):モデルが「陽性(P)」と予測したが、それが「間違っていた(F)」= 実際は陰性(オオカミ少年アラート)
・FN(False Negative / 偽陰性):モデルが「陰性(N)」と予測したが、それが「間違っていた(F)」= 実際は陽性(危険な見逃し)
・TN(True Negative / 真陰性):モデルが「陰性(N)」と予測し、それが「正しかった(T)」= 実際も陰性
文献やライブラリ(Pythonのscikit-learnなど)によって、混同行列の縦軸(行)と横軸(列)の配置が「行=実際、列=予測」の場合と「行=予測、列=実際」の場合があります。表のマス目の位置だけで暗記しようとするとミスを誘発するため、必ず「予測ラベル」と「実際(正解)ラベル」の見出しを確認し、上記の2文字分解ルールを適用するのが鉄則です。

【計算式一覧】正解率・適合率・再現率・F値の違いと使い分け
分類モデルの性能を総合的に評価するため、混同行列の4要素を組み合わせて複数の評価指標が計算されます。代表的な指標である正解率(Accuracy)、適合率(Precision)、再現率(Recall)、そしてF値(F1-Score)の違いと計算式を整理します。
| 指標名(英語) | 計算式 | 重視すべき実務シナリオ | 指標の特徴・注意点 |
|---|---|---|---|
| 正解率 (Accuracy) | (TP + TN) / (TP + FP + FN + TN) | 陽性と陰性のデータ数がほぼ半々(均衡データ)の全体評価 | 直感的で分かりやすいが、異常検知などの不均衡データでは無意味になる |
| 適合率 (Precision) | TP / (TP + FP) | 誤検知(偽陽性)のコストが高い場合(スパム判定、無実の罪防止) | 「陽性と予測したうち、本当に陽性だった割合」。確実なものだけを拾う |
| 再現率 (Recall / 感度) | TP / (TP + FN) | 見逃し(偽陰性)のコストが致命的な場合(病気診断、工場設備の故障検知) | 「実際の陽性のうち、どれだけ漏れなく検知できたか」。網の目の細かさ |
| 特異度 (Specificity) | TN / (TN + FP) | 陰性のものを確実に陰性と判定したい場合(健康診断のスクリーニング後) | 医療統計で頻出。「1 - 偽陽性率」と同義。感度(再現率)と対になる指標 |
| F値 (F1-Score) | 2 × (Precision × Recall) / (Precision + Recall) | 適合率と再現率のバランスを1つの数値で統合評価したいとき | 適合率と再現率の調和平均。極端な偏りがあるモデルには厳しいスコアが出る |
実務において最も重要なのは、「適合率と再現率はトレードオフの関係にある」という点です。判定の閾値(しきい値)を下げて陽性判定を甘くすれば、見逃しが減って再現率は上がりますが、誤検知が増えて適合率は下がります。逆に閾値を厳しくすれば適合率は上がりますが、再現率は低下します。
偽陽性と偽陰性の違い|第一種の過誤・第二種の過誤と現場リスク
統計学および機械学習の運用現場において、判断の成否を分けるのが「偽陽性(FP)」と「偽陰性(FN)」の非対称なリスク構造です。統計的仮説検定の文脈では、偽陽性は「第一種の過誤(Type I Error)」、偽陰性は「第二種の過誤(Type II Error)」と呼ばれます。
これら2つの過誤が現場にもたらすインパクトは、ドメインによってまったく異なります。
■ 医療・人命・セキュリティ分野(偽陰性が致命的)
がん検診のAI診断や自動運転の歩行者検知システムでは、偽陰性(FN:病気や歩行者を見逃すこと)は人命の喪失につながる取り返しのつかない事態を招きます。一方で、偽陽性(FP:健康なのに再検査を促す、何もないのにブレーキがかかる)は再検査の費用や一時的な不便で済みます。したがって、この分野では再現率(感度)の極大化が最優先されます。
■ コミュニケーション・法務・推薦分野(偽陽性が致命的)
電子メールのスパムフィルタにおいて、重要な商談メールや内定通知が誤って迷惑メールフォルダに振り分けられる(偽陽性:FP)と、ビジネス上の損失やユーザーの信頼失墜を招きます。スパムメールが1通受信トレイにすり抜ける(偽陰性:FN)被害のほうが軽微であるため、この場合は適合率の維持が絶対条件となります。
「第一種の過誤」と「第二種の過誤」の学術的な定義に囚われると現場判断が遅れます。「どちらのエラーを起こしたときに、誰がどれだけの損害を被るのか」というコスト構造から逆算して許容エラーを定義することが求められます。

【実態検証】データサイエンティストが陥る評価指標の罠とROC曲線
機械学習のプロジェクト現場において、データ分析者が最も頻繁に遭遇する失敗が「正解率(Accuracy)のパラドックス」です。
例えば、全体の0.1%しか発生しないクレジットカードの不正利用を検知するモデルを構築する場合を考えます。もしモデルが「すべての取引を正常(陰性)」と出力する何の学習もしていない欠陥プログラムだったとしても、正解率は99.9%を達成してしまいます。
このような不均衡データ(Imbalanced Data)において、正解率の高さを誇るモデル報告書は実務的に全く無価値です。実際の不正利用(陽性)を1件も検知できていないため、再現率は0%となります。
こうした罠を回避し、モデル全体の判別能力を正当に評価する手法として不可欠なのがROC曲線(Receiver Operating Characteristic Curve)とAUC(Area Under the Curve)です。
ROC曲線は、分類の閾値を0から1まで連続的に変化させたときの「偽陽性率(1 - 特異度)」を横軸に、「真陽性率(再現率・感度)」を縦軸にプロットしたグラフです。その曲線の下側の面積であるAUCが1.0に近いほど、閾値の設定に関わらず陽性と陰性を綺麗に分離できている優れたモデルであることを示します(ランダムな予測ではAUC=0.5)。
ただし、極端に陽性が少ない極端な不均衡データでは、ROC曲線ですら楽観的な評価になりがちです。現場のシニアエンジニアは、ROC-AUCに加えて「PR曲線(Precision-Recall Curve)のAUC(PR-AUC)」を併用し、適合率の急落が起きていないかを厳しく精査します。
【プロの結論】プロジェクト別・評価指標の選び方と導入判断基準
機械学習モデルを本番環境へデプロイする際、どの評価指標を主要KPIに据えるべきかは、事業の性質とリソースによって論理的に決定されます。
【判断基準】優先すべき指標とプロジェクトの適合チェック
1. 再現率(Recall)を最優先にすべきプロジェクト
・該当ケース:がん・感染症の一次スクリーニング、製造ラインの異物混入検知、構造物の亀裂検出
・判断の理由:「見逃し」の事業コスト・法的リスクが極めて高い。後工程で人間によるダブルチェック(二次検査)が可能なリソース体制が整っている場合に最適です。
2. 適合率(Precision)を最優先にすべきプロジェクト
・該当ケース:高確度リード顧客の自動抽出、アカウントの自動永久BAN(利用停止判定)、重要メールの自動アーカイブ
・判断の理由:「誤認アラート」がユーザー体験の破壊やブランド毀損、無用なクレーム対応コストを引き起こす。システムが自動でアクションを完結させる設計に適しています。
3. F値(F1-Score / F-beta)を指標にすべきプロジェクト
・該当ケース:検索エンジンの関連文書抽出、自然言語処理の固有表現抽出、一般的なクラス分類
・判断の理由:適合率と再現率のどちらも極端に犠牲にできない。適合率と再現率の重要度に差がある場合は、重み付けパラメータを調整したFβスコア(再現率重視ならF2、適合率重視ならF0.5)を採用するのが合理的です。
【tp fp fn tn】に関するよくある質問(FAQ)
Q1:感度・特異度と適合率・再現率の違いは何ですか?
A1:再現率(Recall)と感度(Sensitivity)は全く同じ計算式(TP / [TP + FN])であり、同じ概念です。機械学習や情報検索の分野では「再現率」、医療統計や疫学の分野では「感度」と呼ばれる傾向があります。一方、特異度(Specificity)は「実際の陰性のうち正しく陰性と判定できた割合(TN / [TN + FP])」を指し、感度とセットで医療スクリーニングの性能評価に用いられます。
Q2:混同行列の縦軸と横軸が文献やツールによって逆になっている時の見分け方は?
A2:混同行列を見る際は、マスの配置ではなく必ず軸の見出し(Actual/True=実績値、Predicted=予測値)を確認してください。scikit-learnの`confusion_matrix`は「行(縦)=実績値、列(横)=予測値」で出力されますが、一部のBIツールや統計ソフトでは逆のレイアウトもあります。「予測がPositiveの列(または行)」の中で実績が合っているものがTP、間違っているものがFPとなります。
Q3:3クラス以上の多クラス分類(Multi-class)ではTP・FP・FN・TNをどう計算しますか?
A3:多クラス分類では、注目する1つのクラスを「陽性」、それ以外のすべてのクラスをまとめて「陰性」とみなすOne-vs-Rest(OvR)方式で各クラスごとにTP・FP・FN・TNを算出します。クラスごとの数値を単純平均する「マクロ平均(Macro-average)」や、全サンプルの合算から計算する「マイクロ平均(Micro-average)」を用いて全体の性能を統合します。
まとめ:混同行列を正しく理解し機械学習モデルの真の価値を引き出す
TP・FP・FN・TNの4要素は、機械学習モデルの性能を客観的に評価し、実務への適用可否を判断するための絶対的な基礎言語です。「2文字目の予測結果から読み解き、1文字目で正否を確認する」という原則さえ身につければ、定義を見失うことはなくなります。
単一の正解率に惑わされることなく、課題の特性に応じて適合率・再現率・F値・特異度を戦略的に選択し、適切な閾値調整を行うことが、データサイエンスをビジネスの成果へと結びつける確固たる道筋となります。 (出典: tp fp fn tn(Yahoo!ニュース))
最新のトレンドや話題のニュースをわかりやすく解説するWebライターです。読者の皆様に役立つ情報を日々お届けしています。
