知識獲得のボトルネックとは?AIが直面した限界と克服の歴史を解説
人工知能(AI)が爆発的な進化を遂げ、ビジネスや日常生活のインフラとなった現在でも、AI研究の歴史を語る上で欠かせない歴史的転換点があります。それが1980年代の第2次AIブームを終息へと追い込んだ「知識獲得のボトルネック」です。当時、専門家の知識をコンピュータに移植して高度な意思決定を代行させようとした「エキスパートシステム」は、世界中の企業や研究機関から熱狂的な期待を集めました。
しかし、プロジェクトが実用段階に進むにつれ、開発現場は「人間の知識をどうしてもデータ化・ルール化できない」という絶望的な壁に突き当たります。なぜ人間が当たり前に持っている知識をAIに教え込むことができなかったのか。その構造的理由と、その後の機械学習やディープラーニングがどのようにこの壁を突破したのか、2026年最新の技術動向も交えて徹底的に紐解きます。
📌 【この記事の重要ポイントまとめ】
- 要点1:知識獲得のボトルネックとは、1980年代のエキスパートシステム開発において、人間の持つ膨大な知識や「暗黙知」をコンピュータが理解できるルール(形式知)として記述・抽出することが極めて困難だった問題を指す。
- 要点2:職人や医師などの専門家自身が「なぜその判断に至ったのか」を言語化できない問題に加え、ルールの爆発的な増加による矛盾と保守コストの増大が第2次AIブーム崩壊の決定打となった。
- 要点3:2010年代以降のディープラーニングがデータから「特徴量を自動獲得」したことで問題は大きく克服されたが、2026年現在もハルシネーション対策や暗黙知の獲得を巡る新たな課題として形を変えて議論が続いている。
【基礎からわかる】知識獲得のボトルネックとは?第2次AIブームを失速させた真因
AIの歴史を振り返ると、1950〜1960年代の「探索と推論」を中心とした第1次AIブームに続き、1980年代には「知識」をコンピュータに与えることで賢くする第2次AIブームが到来しました。その中核を担ったのが、医療診断や設計支援、金融取引などを自動化する「エキスパートシステム」です。
エキスパートシステムは、特定の専門領域(ドメイン)におけるルールを「IF〜(もし〇〇なら)、THEN〜(そのときは✕✕である)」という条件分岐の形でコンピュータに蓄積し、推論エンジンによって最適な答えを導き出す仕組みでした。当時、スタンフォード大学のエドワード・ファイゲンバウム教授らが主導した「知識工学(Knowledge Engineering)」の台頭により、世界中で「人間の頭脳をそのままマシンへ移植できる」という熱狂が巻き起こりました。
しかし、このアプローチは瞬く間に限界を迎えます。現実世界の事象はあまりにも複雑で、例外に満ちていました。システムに登録すべきルールは数千、数万と天文学的に膨れ上がり、ルール同士の矛盾が頻発。さらに、専門家にいくらヒアリングしても「肝心な判断基準」をプログラミング言語に落とし込めないという事態が現場で多発したのです。この「人間の知識をコンピュータにインプットする作業そのものが最大の障害になる現象」こそが、知識獲得のボトルネック(Knowledge Acquisition Bottleneck)と呼ばれた歴史的課題です。
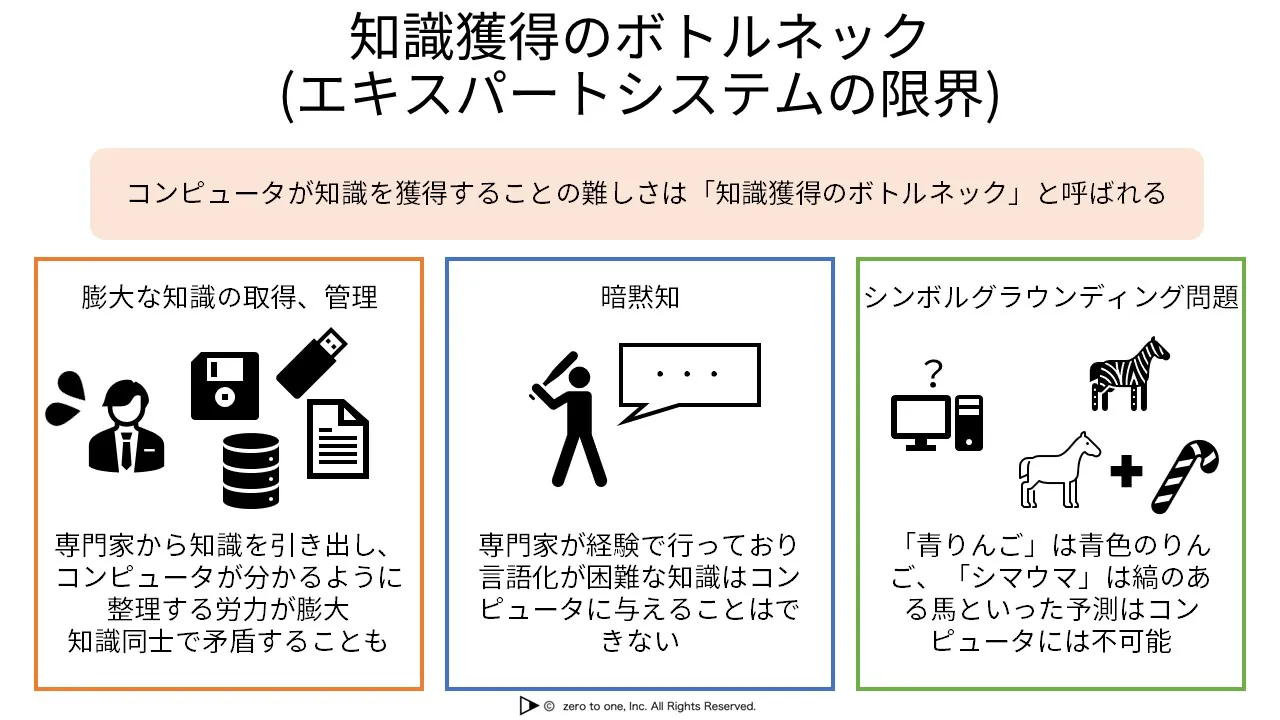
なぜ専門家の頭脳をコピーできなかったのか|暗黙知の言語化とルールベースAIの限界
知識獲得のボトルネックが発生した根本的な原因は、人間の認知構造とコンピュータの処理ロジックの間に横たわる深い溝にありました。主な要因は以下の3点に集約されます。
1. マイケル・ポランニーの「暗黙知」と言語化の壁
ハンガリーの哲学者マイケル・ポランニーは『暗黙知の次元』において、「私たちは語ることができる以上のことを知っている(We can know more than we can tell)」という有名な言葉を残しました。熟練の医師がレントゲン写真を見た瞬間に直感する「わずかな違和感」や、熟練の職人が金属の手触りで判断する「ミクロン単位の歪み」は、本人の無意識の経験則(暗黙知)に基づいています。
当時の知識工学者(ナレッジエンジニア)が専門家に綿密なインタビューを行っても、専門家自身が「なぜそう判断したのか」を論理的な文章や数値で説明できませんでした。ナレッジマネジメントにおけるSECIモデル(野中郁次郎氏らが提唱)で示される「暗黙知から形式知への変換」が、個人の直感や感覚の領域において完全に立ち往生してしまったのです。
2. ルールベースAIが引き起こす「知識の爆発」と矛盾
ルールベースAIでは、例外が発生するたびに新しいIF-THENルールを追加する必要があります。しかし、ルールが1万件を超えたあたりから、システム全体で論理的な整合性を保つことが不可能になりました。「ルールAを適用するとルールBと衝突する」といったデッドロックが日常茶飯事となり、システムの改修コストが運用効果を上回る逆転現象が起きたのです。
3. コンテキスト(文脈)と常識の欠如
人間は会話や判断を行う際、無意識のうちに膨大な「常識」や「その場の文脈」を補完しています。しかし、ルールベースのコンピュータには「コップを逆さまにすると水がこぼれる」「人は疲れると集中力が落ちる」といった日常的な常識すら存在しません。これら背景となる知識をすべて手作業で入力しようとする試み(オントロジー工学やCycプロジェクトなど)も行われましたが、世界のすべてを網羅して記述することは人間にとって不可能な作業でした。
【徹底比較】歴代AIアプローチと知識獲得手法の進化と限界
知識をどのようにしてコンピュータに持たせるかというアプローチは、AIの歴史そのものです。第2次のルールベースから現代の大規模言語モデル(LLM)に至るまでの違いを、客観的なデータと特徴で比較します。
| 時代・アプローチ | 知識の獲得方法 | 直面した主要課題 | 編集部の見解・評価 |
|---|---|---|---|
| 第2次AI(1980年代) エキスパートシステム | 人間(知識工学者)が手作業でルールをIF-THEN形式で記述 | 知識獲得のボトルネック、暗黙知の記述不可、保守不能 | 閉じた限定的環境では有効だったが、現実世界の複雑さに耐えられず失速した。 |
| 第3次AI前期(2000年代) 統計的機械学習 | 人間が「特徴量」を設計し、大量データから統計的に学習 | 特徴量設計の限界(特徴量を決める人間のセンスに依存) | データの統計処理によりルール記述から脱却したが、特徴量の抽出に人間の介入が必要だった。 |
| 第3次AI後期(2010年代) ディープラーニング | ニューラルネットワークがデータから「特徴量」を自動抽出 | ブラックボックス問題(説明責任の欠如)、大量のラベル付きデータ依存 | 画像や音声の認識において人間の暗黙知(パターンの直感)を機械が自律獲得し、歴史的ブレイクスルーを達成。 |
| 現在(2026年最新) 基盤モデル・LLM融合 | Web規模のマルチモーダルデータから汎用的知識を自己教師あり学習 | ハルシネーション(事実誤認)、最新リアルタイム知識の同期コスト | 知識の獲得自体は自動化されたが、知識の「正確性」と「記号的論理の厳密さ」の担保が新課題に。 |

シンボルグラウンディング問題との決定的な違い|一般に混同されがちな盲点と誤解
AIの限界を論じる際、ネット上の解説や初学者の間で頻繁に混同されるのが「知識獲得のボトルネック」と「シンボルグラウンディング問題(記号接地問題)」、そして「フレーム問題」の3大難問です。これらは異なるレイヤーの課題であり、正確に区別して理解する必要があります。
1. 知識獲得のボトルネック(入力プロセスの問題)
「人間が持っている膨大な知識やノウハウを、どのようにしてコンピュータが扱える形式に落とし込むか」という知識のインプット・記述コストの限界です。知識を書き出す側の人間側の制約(言語化の限界)と、システム側の構造的制約を指します。
2. シンボルグラウンディング問題(意味理解・認識の問題)
認知科学者スティーブン・ハルナッドが1990年に提唱した問題で、「コンピュータが扱う記号(シンボル:例えば『シマウマ』という文字列)が、現実世界の物理的対象や感覚データとどのように結びついているのか(接地しているのか)」を問うものです。AIは「シマウマ=縞模様のある馬」という辞書的知識を操作できても、実際のシマウマを見たときの視覚的実体や「縞模様」の意味そのものを真に理解しているわけではないという根本的な問いです。
3. フレーム問題(計算量の問題)
哲学者ジョン・マッカーシーらが提唱した、「今からしようとしている行動に関係のある知識だけを枠づけて(フレーム化して)選び出すことができない」という問題です。現実世界の無限の要素の中から、「何が関係していて、何が関係していないか」を判断するだけでAIの計算量が爆発してしまう限界を指します。
要約すると、「知識を入力しきれなかった」のが知識獲得のボトルネックであり、「入力された記号の意味をAI自身が体感・理解していない」のがシンボルグラウンディング問題です。ディープラーニングはマルチモーダル学習によって記号接地を大幅に前進させましたが、根本的な意味理解については現代でも哲学・情報科学のホットな議論が続いています。
機械学習とディープラーニングによる克服|人工知能の歴史を変えた転換点
1990年代の「AIの冬(冬の時代)」を経て、2000年代以降に登場した機械学習(Machine Learning)、そして2010年代のディープラーニング(深層学習)は、知識獲得のパラダイムを根底から覆しました。
従来のルールベースAIでは、人間が「猫とは、尖った耳があり、ヒゲが生えていて、丸い目をした動物である」とすべての特徴をコードで教えていました。しかし、寝転がっている猫や、後ろを向いている猫をこのルールで判定することは不可能です。
ディープラーニングがもたらした革命は、「特徴量表現学習(Feature Learning)」の自動化でした。何百万枚もの猫の画像をニューラルネットワークに流し込むことで、AI自身が画像の濃淡やエッジ、テクスチャの組み合わせから「猫を猫たらしめるパターン」を数学的な重み(ウェイト)として自動的に抽出・獲得したのです。
かつて知識工学者が専門家に何日もインタビューしても書き出せなかった「熟練の眼力」や「直感」という暗黙知が、ビッグデータと多層ニューラルネットワークによる統計的重み付けという形で、人間の言語化を介さずにAI内部へ直接獲得されるようになりました。これが「知識獲得のボトルネックを打ち破った歴史的転換点」です。

【2026年最新動向】知識獲得のボトルネックは完全消滅したのか?現場の実態
ディープラーニングとLLMの爆発的普及により、一般的な知識の獲得コストは劇的に低下しました。しかし、2026年現在のエンタープライズ現場や先端研究において、「知識獲得のボトルネックは完全に消えた」と言い切ることはできません。むしろ、形を変えて新たな課題が浮き彫りになっています。
1. クローズドな現場における「超専門的暗黙知」の壁
一般的なWebデータや公開マニュアルに存在する知識はLLMが網羅しましたが、製造業の金型調整ノウハウ、最先端バイオ研究の実験手技、地方自治体の特有の運用ルールといった「社外に出ていない非構造化データ」の獲得は、現在でも各企業の深刻な課題です。社内Wikiや業務チャットのログをLLMにRAG(検索拡張生成)で読み込ませても、肝心のキーマンの頭の中にしかない判断基準を拾い上げられないという、1980年代と酷似した現象が再発しています。
2. ハルシネーションと「正確な知識表現」の再評価
ディープラーニングやLLMは統計的確率で次の言葉を予測するため、時に事実と異なる「もっともらしい嘘(ハルシネーション)」を出力します。この問題を抑え込むため、2026年現在ではナレッジグラフ(知識グラフ)やオントロジー(概念体系)といった記号論的アプローチと、ニューラルネットワークを融合させる「ニューロシンボリックAI」への回帰と進化が急速に進んでいます。
完全な自動学習(ブラックボックス)だけに頼るのではなく、企業のコアコンピタンスとなる基幹知識を「形式知化(ナレッジグラフ化)」し、柔軟なLLMの推論エンジンと組み合わせるハイブリッド型のシステム設計が業界標準となっています。
【プロの結論】AI導入で失敗しないための判断基準と組織が学ぶべき教訓
知識獲得のボトルネックという歴史的事実から、現代のビジネスパーソンやエンジニアは何を学ぶべきでしょうか。過去の失敗と最新テクノロジーの特性を照らし合わせると、システム導入の明確な判断基準が見えてきます。
【適性判定】どちらのアプローチを採用すべきか?
- ルールベース/厳密な形式知化が向いている領域:
- 税法や会計基準の計算、コンプライアンスチェックなど「100%の正確性と根拠の説明」が法的に義務付けられている業務
- 入力と出力の関係が完全に決定論的で、例外のパターンが有限かつ明確なシステム
- 機械学習・LLM(データ駆動型)が向いている領域:
- 画像診断、音声認識、不正検知など「言語化は難しいがデータパターンが存在する」業務
- カスタマーサポートの一次応答、マーケティング文案の生成、長文要約など文脈の柔軟な理解が求められる業務
組織が直面する「知識の継承」への教訓
AIはデータを食べることで成長しますが、人間組織における「暗黙知を共有するカルチャー」が存在しなければ、AIに与えるべき良質なデータすら生まれません。第2次AIブームの失敗が教えてくれる最大の教訓は、「テクノロジーだけで人間の英知を丸ごと代替することはできない」という点です。人間側が業務の棚卸しとナレッジマネジメント(形式知化の努力)を怠ったままAIを導入しても、現代でも同じ轍を踏むことになります。
【知識獲得のボトルネック】に関するよくある質問(FAQ)
Q1:知識獲得のボトルネックを一言でわかりやすく言うと?
A1:人間の頭の中にある経験や勘(暗黙知)を、コンピュータが処理できるルールやデータとして書き出す作業が難しすぎて、AIの開発が進まなくなった歴史的な壁のことです。
Q2:なぜ第2次AIブームの時代にこれが大きな問題になったのですか?
A2:当時は「人間が手作業ですべてのルール(IF-THEN)を記述する」手法しか存在しなかったためです。専門家の知識を言葉にしきれず、ルールを増やすとシステムが矛盾して破綻してしまいました。
Q3:ディープラーニングの登場でこの問題は完全に解決しましたか?
A3:画像や音声などのパターン認識における知識獲得は大幅に解決されました。しかし、企業の独自ノウハウや言語化されていない熟練技の獲得、またAIが嘘をつくハルシネーションの制御など、現在も形を変えた新たな知識獲得の課題が残っています。
Q4:オントロジー工学とは何ですか?ボトルネックと関係がありますか?
A4:オントロジー工学とは、概念や知識の体系をコンピュータが扱えるように厳密に定義・構造化する学問です。知識獲得のボトルネックを解消するために1990年代以降に大きく発展し、現代のナレッジグラフや検索エンジンの基盤技術として受け継がれています。
まとめ:歴史に学びAIを真のビジネス価値へ昇華させる
「知識獲得のボトルネック」は、単なる過去の技術的挫折ではありません。人間が持つ知性の本質とは何か、そしてコンピュータは何が得意で何が苦手なのかを浮き彫りにした、AI研究史上最も重要な教訓の一つです。
手作業によるルール記述から、機械による特徴量の自己獲得、そしてLLMによる言語・世界のモデリングへと進化を遂げた現代だからこそ、私たちは「AIにどのような知識を、いかなる形式で託すべきか」を冷静に見極める必要があります。歴史の転換点となったこのボトルネックの構造を正しく理解することは、激変する2026年以降のテクノロジー社会を生き抜くための確かな羅針盤となるはずです。 (出典: 知識 獲得 の ボトル ネック(Yahoo!ニュース))
情報を整理して届けることが得意なWebディレクター。ユーザー視点に立った記事作成を目指しています。
