第2種の過誤とは?偽陰性の防ぎ方と第1種との違い・覚え方を徹底解説
データドリブンな意思決定が組織の命運を分ける今、仮説検定の現場で最も恐れられている落とし穴が「本当は効果があるのに、それを見逃してしまう」という致命的なミスです。統計学ではこれを第2種の過誤(別名:βエラー、偽陰性)と呼びます。新規施策のABテストや製品の品質検査、さらには医療の臨床試験に至るまで、この過誤を正しくコントロールできていない企業は、莫大な投資機会や救えるはずの価値を日々ドブに捨てていると言っても過言ではありません。
統計検定の学習者や実務担当者の多くが「第1種の過誤と第2種の過誤がごちゃ混ぜになる」「数式は理解できても、現場でどう対策すべきか分からない」という壁にぶつかります。本稿では、見落としが発生する本質的なメカニズムから、ビジネス現場における具体的な失敗例、検出力(1-β)を引き上げるサンプルサイズ計算の勘所、そして試験でも実務でも一生忘れない記憶の定着法まで、余すところなく解き明かします。
📌 【この記事の重要ポイントまとめ】
- 要点1:第2種の過誤は「対立仮説が正しい(真実として差がある)にもかかわらず、帰無仮説を棄却できずに見落とす」ミス(偽陰性)を指す。
- 要点2:第1種の過誤(偽陽性:αエラー)とはシーソーのようなトレードオフ関係にあり、両方を同時に抑える唯一の鍵はサンプルサイズの適切な拡大である。
- 要点3:「有意差が出なかった=効果がなかった」と短絡的に片付ける現場の勘違いこそが、最大の機会損失とビジネス停滞を生み出している。
【基本定義】第2種の過誤とは?第1種の過誤との決定的な違い
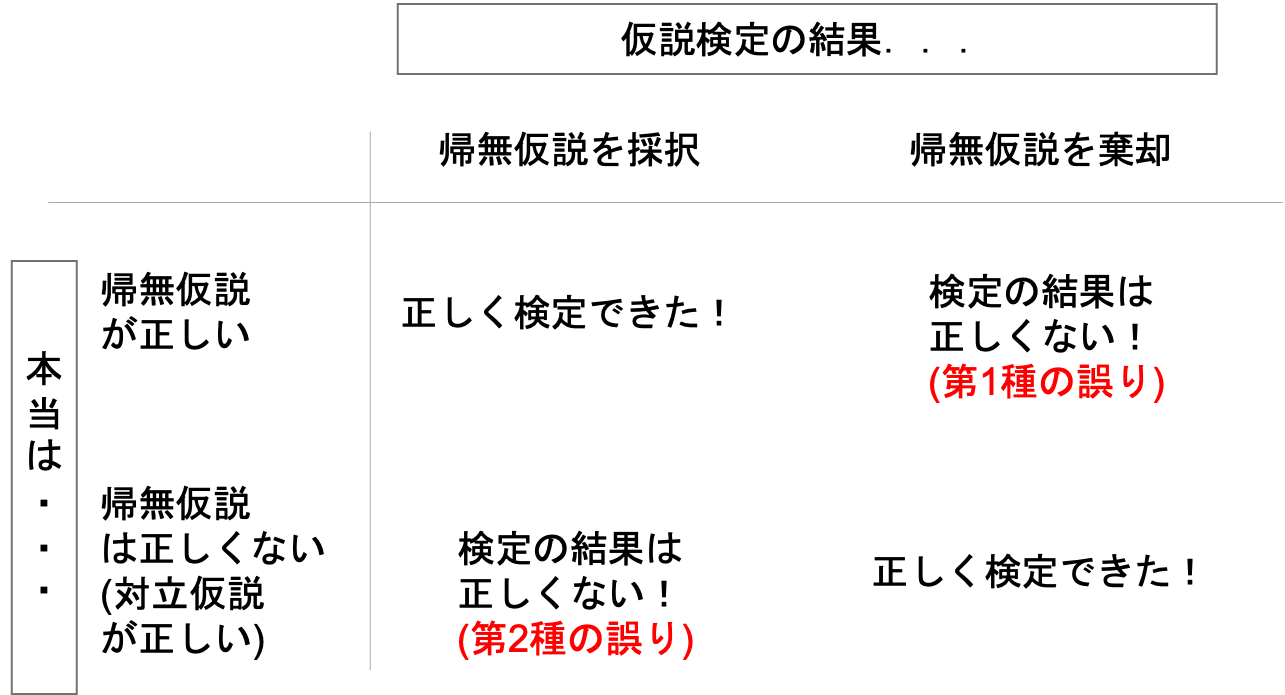
統計的仮説検定の枠組みにおいて、私たちが立てる前提には常に2つの仮説が存在します。否定したい基本の前提である帰無仮説(H0:差はない、効果はない)と、実証したい本命の対立仮説(H1:差がある、効果がある)です。この2つの仮説をデータに基づいて判定する際、神のみぞ知る「客観的事実」と人間の「判定結果」のズレから生じるのが、以下の2つの誤りです。
まず第1種の過誤(Type I Error)とは、「実際には効果がない(帰無仮説が真)」のに、偶然の偏りによって「効果がある(帰無仮説を棄却)」と誤判定してしまうエラーです。別名をアルファエラー、あるいは偽陽性(False Positive)と呼び、学術界では「あわてんぼうの誤り」とも表現されます。一般的にこの発生確率は有意水準(α)として、事前に5%(0.05)や1%(0.01)といった厳格な基準値に固定して制御します。
これに対し、本稿の主題である第2種の過誤(Type II Error)は、「実際には効果がある(対立仮説が真)」のに、データのばらつきや検定力の不足によって「効果があるとは言えない(帰無仮説を採択・保留)」と見過ごしてしまうエラーを指します。別名をベータエラー、あるいは偽陰性(False Negative)と呼び、こちらは「ぼんやりものの誤り」と称されます。この誤りが起きる確率をβと表します。
実務と学術における両者の立ち位置を整理したのが以下の比較データです。
| 項目 | 第1種の過誤(αエラー) | 第2種の過誤(βエラー) | 実務における本質的リスク |
|---|---|---|---|
| 別名・通称 | 偽陽性(あわてんぼうの誤り) | 偽陰性(ぼんやりものの誤り) | 誤認(余計なコスト発生)vs 見落とし(機会の逸失) |
| 現実の真実 | 帰無仮説が正しい(差はない) | 対立仮説が正しい(差がある) | 判定の前提となる母集団の真理 |
| 検定の判断 | 帰無仮説を棄却(差があると判断) | 帰無仮説を保留(差がないと判断) | データから導き出された行動方針 |
| 許容水準の目安 | α = 0.05(5%)または 0.01 | β = 0.10〜0.20(10〜20%) | βは通常、αよりも甘く設定されやすい |
| 対となる指標 | 信頼水準(1 - α)= 95% | 検出力(1 - β)= 80〜90% | 「差を正しく差と見抜く力」が検出力 |
【現場の悲劇】見落としが起きる決定的な理由と実務での具体例
第2種の過誤がなぜ現場でこれほど軽視され、そして莫大な損害をもたらすのか。それは、多くのビジネスマンが「P値が0.05を下回らなかった」という表面的な結果だけを見て、「P ≧ 0.05 だからこの施策は意味がなかった」と誤認してしまうからです。代表的な3つの第2種の過誤 具体例から、その深刻なリスクを浮き彫りにします。
第1の例は、デジタルマーケティングにおけるWebサイトのABテストです。あるECサイトで、決済ボタンの配置とコピーを大幅に改善したB案を作成しました。このB案は、実際にはコンバージョン率を確実に1.2%引き上げる本物の効果を持っていたとします。しかし、担当者はわずか3日間のテスト、各群1,500PV程度の不十分なデータ量で検定を実施しました。結果は「P = 0.14(有意差なし)」。現場は「改善効果は見られなかった」と判断し、B案を即座に破棄しました。真実の売上成長の種を自らの手で握りつぶしてしまった典型例であり、これこそが第2種の過誤の正体です。
第2の例は、製造業における不良品スクリーニングです。工場の出荷ラインにおいて、あるロットに重大な欠陥が混入している(対立仮説が真)にもかかわらず、抜き取り検査のサンプル数が少なすぎたために異常を検知できず、「基準適合」として市場に出荷してしまうケースです。市場流出後に製品リコールへと発展し、数十億円規模の回収費用とブランド失墜を招く惨事となります。
第3の例は、医療機器や新薬の有効性検証です。既存薬よりも副作用が少なく優れた効果を持つ新薬候補が、被験者数(n数)の不足によって有意水準をクリアできず、治験が開発中止に追い込まれる事例が後を絶ちません。製薬企業にとっては何百億円という研究開発費の損失であり、患者にとっては新たな治療の選択肢を奪われることを意味します。
【直感で納得】絶対に忘れない第2種の過誤の覚え方
資格試験対策やデータ分析のミーティングで「どっちが第1種で、どっちが第2種だっけ?」と迷わないための、実践的な第2種の過誤 覚え方を伝授します。最も定着率が高いのは「社会の童話」と「擬人化」を使った記憶アプローチです。
まず圧倒的に覚えやすいのが、イソップ寓話の『オオカミ少年』に例える手法です。
- 第1種の過誤(オオカミが来ていないのに、来たと叫ぶ):本当は何もないのに大騒ぎする「あわてんぼうの嘘つき少年」。これが偽陽性です。
- 第2種の過誤(本当にオオカミが来たのに、誰も気づかない):本物の危機が迫っているのに無視してやり過ごす「ぼんやりものの村人たち」。これが見落とし、すなわち偽陰性です。
もう一つのアプローチは、医療の「検査結果のコール順」と番号をリンクさせる方法です。検診の現場では、異常があることを「陽性(Positive)」、異常がないことを「陰性(Negative)」と呼びます。
アルファベットや数値の順序として、「1番目=陽性(偽陽性)」、「2番目=陰性(偽陰性)」と脳内で紐付けます。「1はポジティブ(陽性)の過ち、2はネガティブ(陰性)の過ち」と唱えるだけで、統計検定の試験会場でも瞬時に回答を導き出せるようになります。
【数学的メカニズム】検出力(1-β)とサンプルサイズ計算の関係
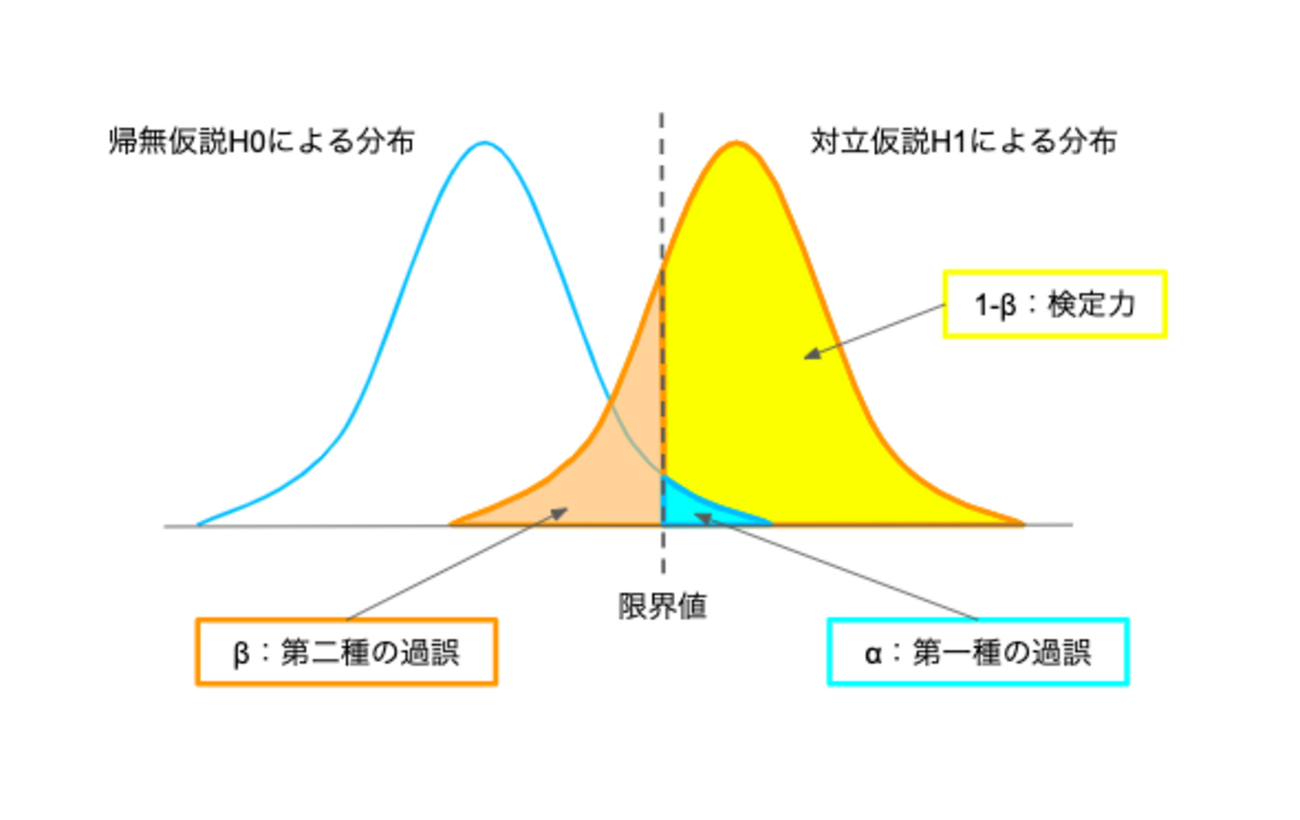
第2種の過誤を未然に防ぐ上で避けて通れないのが、統計学における検出力(Statistical Power)の概念です。検出力とは、数式で表すと「1 - β」となります。つまり、「差があるときに、正しく差があると見抜く確率」そのものです。一般的に実務や臨床試験では、検出力を80%(0.80)以上、理想的には90%(0.90)に設計することが標準的なプロトコルとされています。
ここで重要な数学的真実があります。第1種の過誤の確率(α)と第2種の過誤の確率(β)は、サンプルサイズが一定である限り、トレードオフの関係にあります。偽陽性を極度に恐れて有意水準を「α = 0.01(1%)」のように厳しく設定すると、棄却のハードルが上がるため、必然的に本物の差を見落とす確率βは跳ね上がります。
では、αを5%に保ったまま、見落とし(β)を20%以下に抑える(検出力を80%以上にする)にはどうすればよいのか。その唯一の解決策がサンプルサイズ 計算による事前の標本設計です。
サンプルサイズ(n)を決定する計算式は、2群の平均値の差の検定(t検定)を例にとると、概念的に次のような構造を持ちます。
n ≒ 2 × [(Zα/2 + Zβ) × σ / Δ]2
ここで、Zα/2は有意水準に対応する標準正規分布の値(両側5%なら約1.96)、Zβは検出力に対応する値(80%なら約0.84)、σはデータの標準偏差、Δ(デルタ)は検出したい最小の効果量(差の大きさ)です。この式が意味している決定的なファクトは以下の3点です。
- 検出したい差(効果量)が小さいほど、二乗に比例して膨大なサンプルが必要になる
- データのばらつき(標準偏差)が大きいほど、より多くのサンプルを要する
- 検出力(1-β)を高めようとするほど、必要なサンプル数は激増する
データ収集が終わった後に「有意差が出なかった」と頭を抱えても手遅れです。テストを開始する前に「どの程度の差を見出したいのか」「そのために必要なサンプルサイズはいくつか」を逆算することこそが、第2種の過誤を構造的に排除するプロの作法です。
【実態検証】SNSや現場で多発する「有意差なし=効果なし」の誤解
近年、大手テック企業やデータサイエンスコミュニティ(Xや知恵袋、社内Slackの分析相談室など)で頻繁に紛糾しているのが、いわゆる「P値依存症」による意思決定の麻痺です。
「施策を打ったが、P値が0.08だったため有意差なし。よってこの機能改善は却下とします」というプロダクトマネージャーの報告に対し、シニアデータサイエンティストから「待った」がかかる光景が日常茶飯事となっています。実際の現場ログを追跡すると、サンプルサイズ設計を怠ったまま短い期間でテストを打ち切った結果、βエラーが50%を超えていた(=コイントスと同じ確率で本物の改善を見逃していた)という事例が極めて多いのです。
統計学の国際的学術機関であるアメリカ統計学会(ASA)は、過度なP値偏重に対する声明を発表し、「P値が特定の閾値(例えば0.05)を超えたことだけをもって、効果がないと結論づけてはならない」と強く警鐘を鳴らしています。「差がない」のではなく、「現在のデータ量では差があると言い切る証拠が足りない(検定力不足)」だけにすぎない状態を、現場のバイアスが「無価値」とすり替えてしまう心理的メカニズムが存在します。
【プロの結論】おすすめできる人・慎重になるべき人の判断基準
統計的検定を実務に適用する際、すべての場面で第1種の過誤と第2種の過誤を同じ比重で警戒してはいけません。扱うビジネスの性質と損害の非対称性に応じて、どちらを最優先で防ぐべきかを峻別するリテラシーが求められます。
【第1種の過誤(偽陽性)を極限まで警戒すべきケース】
- 新薬の認可・医療手術:本当は毒性や効果がないものを「効く」と誤認して世に出した場合、患者の生命と健康に取り返しのつかない打撃を与える。
- 巨額の設備投資:数十億円の工場新設など、一度投資すると後戻りできない不可逆な意思決定。
- 刑事裁判の有罪判決:「疑わしきは罰せず」の原則通り、無実の人(帰無仮説が真)を犯人と決めつける過誤を最優先で排除する。
【第2種の過誤(偽陰性)を絶対に放置してはならないケース】
- 空港の保安検査・感染症スクリーニング:危険物所持者や感染者を「問題なし」と見逃すことは、即座に大事故やパンデミックを招く。ここでは多少の誤報(偽陽性)を出してでも、見落とし(偽陰性)をゼロに近づける設計が不可欠。
- スタートアップの初期プロダクト改善:資本力が限られる中で、わずかな改善の兆候を見逃して破棄することは企業の死に直結する。αを0.10や0.20に緩めてでも、チャンス(対立仮説)を掴み取る嗅覚が優先される。

【第2種の過誤】に関するよくある質問(FAQ)
Q1:第2種の過誤の許容水準(β)は一般的にどのくらいで設定しますか?
A1:ビジネス実務や一般的な臨床研究では、β = 0.20(20%)、すなわち検出力(1-β)= 80%に設定することが業界標準です。より確実性を重視する重要プロジェクトでは、β = 0.10(検出力90%)に引き上げるケースもありますが、そのぶん必要なサンプルサイズが大幅に跳ね上がります。
Q2:第1種の過誤と第2種の過誤を両方同時にゼロにすることは可能ですか?
A2:母集団の全数調査を行わない標本抽出の検定である限り、理論上、両方を完全にゼロにすることは不可能です。ただし、サンプルサイズを無限大に近づければ、両方の誤りを極限までゼロに近づけることはできます。現実の実務では、許容できるコスト・時間とリスクのバランスを考慮して数値を決めます。
Q3:検定結果が「有意差なし」だった場合、現場ではどう対処すべきですか?
A3:単に施策を却下するのではなく、まず「事後検出力(Post-hoc Power)」や信頼区間の幅を確認してください。信頼区間が広く、必要なサンプルサイズに達していないことが判明した場合は、「テスト期間を延長してサンプルを追加収集する」か、「効果量の事前見積もりを見直す」のが正しいアプローチです。
まとめ:データに振り回されない意思決定を手に入れるために
仮説検定は、不確実な世界から真実をあぶり出す極めて強力な武器です。しかし、第1種の過誤を恐れるあまりに厳格な判定基準ばかりに目を奪われていると、第2種の過誤という巨大な盲点に足元をすくわれます。
「有意差が出なかった」という言葉の裏に、どれだけの価値ある変化が見過ごされているか。その危機感を持ち、事前に適切なサンプルサイズを計算し、検出力を設計すること。これこそが、単なる数字の集計係から、事業の成長を真に牽引する一流の意思決定者へと飛躍するための決定的な境界線となります。 (出典: 第 2 種 の 過誤(Yahoo!ニュース))
最新のトレンドや話題のニュースをわかりやすく解説するWebライターです。読者の皆様に役立つ情報を日々お届けしています。
