データの読み込み例
膨大なデータから因果関係を解き明かし、将来予測やグループ分類を可能にする多変量解析。統計学をバックボーンに持つR言語は、学術研究のみならず2026年現在のビジネスデータ分析現場においても極めて高いシェアと信頼性を誇ります。一方で、プログラミングや統計理論の壁に直面し、関数の使い方や出力結果の読み解き方で挫折してしまう実務者が少なくありません。
本稿では、Rと統合開発環境「RStudio」を用いたデータ解析の基礎から、重回帰・主成分・因子・判別・クラスター分析といった主要手法の実践コード、さらには現場で頻発するエラーの回避法までを網羅的に解説します。単なる構文の羅列にとどまらず、現場目線での多変量解析結果の解釈方法と分析設計の勘所を徹底的にお届けします。
📌 【この記事の重要ポイントまとめ】
- 要点1:多変量解析の成否は「予測・要約・分類」という目的に応じた適切なアルゴリズム選定と、tidyverseを活用した前処理にかかっている。
- 要点2:重回帰・ロジスティック回帰・主成分分析などの主要手法は、Rの標準関数および代表的パッケージ(psych, MASSなど)で数行のコードから実行可能。
- 要点3:p値や決定係数だけに囚われず、多重共線性(VIF)の確認や残差診断、寄与率の吟味を行うことが実務における再現性と信頼性を担保する。
【全体像を掴む】多変量解析の主要手法と目的別の選び方マップ
多変量解析とは、3つ以上の変数(データ項目)が持つ相互関係を数学的に分析する手法の総称です。実務で手法を選択する際、最初に問うべきは「目的変数(予測・説明したい対象)が存在するかどうか」です。目的変数がある場合は「教師あり(予測・影響度測定)」、ない場合は「教師なし(要約・パターンの抽出)」に大別されます。
分析手法ごとの目的、入力データの型、代表的なR関数をまとめた比較表は以下の通りです。
| 手法名 | 主な目的・用途 | 目的変数の有無と尺度 | Rの代表的関数・パッケージ |
|---|---|---|---|
| 重回帰分析 | 連続数値の予測、要因の影響度把握 | あり(連続量:売上、気温など) | lm() (stats) |
| ロジスティック回帰分析 | 2値(成否・離脱等)の発生確率予測 | あり(二値カテゴリー:0/1) | glm(family=binomial) |
| 判別分析 | 所属グループの境界線特定と判別 | あり(名義尺度:多クラス可能) | lda(), qda() (MASS) |
| 主成分分析(PCA) | 多次元データの次元削減・総合指標化 | なし(連続変数群を縮約) | prcomp() (stats) |
| 因子分析 | 背後にある潜在因子の特定(アンケート等) | なし(潜在構成概念を探索) | fa() (psych), factanal() |
| クラスター分析 | 似た者同士のグループ分け(セグメンテーション) | なし(階層型・非階層型) | hclust(), kmeans() |
まずは分析のゴールが「現象の予測」なのか「構造の要約・可視化」なのかを明確に定義し、適切なモデルを選択することがプロジェクトの成否を分ける出発点となります。

【環境構築と前処理】RStudio統計解析手順とtidyverseデータ前処理の鉄則
解析に入る前の必須ステップとして、環境整備とデータ前処理が存在します。現代のR言語 多変量解析 入門においてデファクトスタンダードとなっているのが、統合開発環境「RStudio」とモダンなデータ操作群を提供する「tidyverse」パッケージです。
1. 基本的なRStudio 統計解析 手順
RStudioを立ち上げたら、まず作業用スクリプト(.R)を作成し、再現性を確保するためにプロジェクトディレクトリを設定します。必要なライブラリ群をロードした後、CSV等の外部データをデータフレームとして取り込みます。
# 必須パッケージのインストールと読み込み install.packages(c("tidyverse", "psych", "MASS", "car", "corrplot")) library(tidyverse) df <- read_csv("sales_data.csv") head(df) glimpse(df) 2. tidyverse データ前処理の重要ステップ
現場の生データには、欠損値(NA)、外れ値、単位の異なるスケール(円、件数、パーセンテージなど)が混在しています。多変量解析にかける前に、以下の手順でクレンジングを行います。
# 欠損値の確認と除去(あるいは補完) df_clean <- df %>% drop_na() %>% filter(revenue > 0) # 変数の標準化(平均0、標準偏差1に揃える) # ※主成分分析やクラスター分析、正則化回帰では必須 df_scaled <- df_clean %>% mutate(across(where(is.numeric), scale)) 3. 散布図行列 pairs 相関分析による予備探索
モデル構築の直前に、各変数間の線形関係や多重共線性の兆候を視覚化します。標準のpairs()関数、あるいは相関行列を視覚化するライブラリを用います。
# 散布図行列の出力 pairs(df_clean[, 1:5], main ="散布図行列による多変量データの概観") # 相関行列のヒートマップ作成 library(corrplot) cor_matrix <- cor(df_clean %>% select(where(is.numeric))) corrplot(cor_matrix, method ="circle", type ="upper", tl.col ="black") 相関係数が0.8以上となるペアが存在する場合、後述する重回帰分析において「多重共線性」を引き起こすリスクがあるため、事前の変数除外や統合を検討しなければなりません。
【目的・予測】重回帰分析・ロジスティック回帰・判別分析の実践
目的変数を説明変数群によってモデル化する「教師あり」手法の具体的な実装と読み解き方を取り上げます。
1. 重回帰分析 R 使い方:売上要因の特定と予測
連続値を予測する重回帰分析は、lm()関数を用いて「目的変数 ~ 説明変数1 + 説明変数2」というフォーミュラ形式で指定します。
# 重回帰モデルの構築 model_lm <- lm(revenue ~ ad_spend + price + store_size, data = df_clean) # 結果の出力 summary(model_lm) # 多重共線性(VIF)の診断 library(car) vif(model_lm) 結果の解釈ポイント:
出力画面(summary)で最初に見るべきは、各変数のp値(Pr(>|t|))が一般に0.05未満であるかどうかです。さらに「Adjusted R-squared(自由度調整済み決定係数)」でモデル全体の当てはまりの良さを確認します。vif()の値が10以上(厳密には5以上)を示す変数は多重共線性を疑い、モデルからの除外を検討します。
2. ロジスティック回帰分析 R:成約確率や離脱確率のモデリング
顧客の解約有無(0または1)などを扱う場合は、一般化線形モデルであるglm()を用います。
# ロジスティック回帰モデルの構築 model_logit <- glm(churn ~ tenure + monthly_charges + support_calls, data = df_clean, family = binomial(link ="logit")) summary(model_logit) # オッズ比の算出(信頼区間付き) exp(cbind(OddsRatio = coef(model_logit), confint(model_logit))) 回帰係数そのままだと直感的に理解しにくいため、exp()で指数変換してオッズ比を算出します。オッズ比が1より大きければ事象の発生率を高める要因、1未満であれば低下させる要因と判断します。
3. 判別分析 R言語 実装:グループ境界線の算出
カテゴリ変数が3群以上ある場合や、線形境界線で分類したい場合はMASSパッケージのlda()(線形判別分析)を使用します。
library(MASS) # 線形判別分析の実行 model_lda <- lda(Species ~ Sepal.Length + Sepal.Width + Petal.Length + Petal.Width, data = iris) # 判別結果のプロット plot(model_lda, col = as.numeric(iris$Species)) 
【要約・構造把握】主成分分析・因子分析・クラスター分析のRスクリプト
目的変数を定めず、データの背景にある潜在的な特徴や集団構造を抽出する「教師なし」手法を解説します。
1. 主成分分析 Rコード:次元削減と総合スコア算出
多数の変数を少数の主成分に縮約する主成分分析(PCA)には、標準関数prcomp()を使用します。単位の差異による影響を排除するため、引数にscale = TRUEを設定するのが鉄則です。
# 主成分分析の実行(標準化を同時に適用) pca_res <- prcomp(df_clean %>% select(where(is.numeric)), scale. = TRUE) # 寄与率の確認 summary(pca_res) # バイプロット(サンプルと変数の関係を2次元可視化) biplot(pca_res, cex = c(0.7, 1), col = c("gray50", "red")) 多変量解析 結果の解釈方法:累積寄与率が70〜80%に達するまでの主成分を採用するのが一般的な目安です。主成分負荷量(Rotation)の正負や大きさから「第1主成分は総合的な企業規模」「第2主成分は収益性」といった意味付けを行います。
2. 因子分析 R パッケージ:心理・顧客満足度データの潜在因子探索
主成分分析が「要約」であるのに対し、因子分析は「観測されたデータの背後に共通の原因(因子)がある」と仮定する手法です。高機能なpsychパッケージのfa()関数が広く使われます。
library(psych) # 因子数の決定(平行分析スクリープロット) fa.parallel(df_clean %>% select(where(is.numeric)), fa ="fa") # 因子分析の実行(最尤法・プロマックス回転の例) fa_res <- fa(r = df_clean %>% select(where(is.numeric)), nfactors = 3, rotate ="promax", fm ="ml") print(fa_res$loadings, cutoff = 0.3) 因子負荷量を確認し、0.3〜0.4以上の強い結びつきを持つ項目群から「安心感因子」「機能性因子」など潜在概念を命名・定義します。
3. クラスター分析 R スクリプト:顧客セグメンテーション
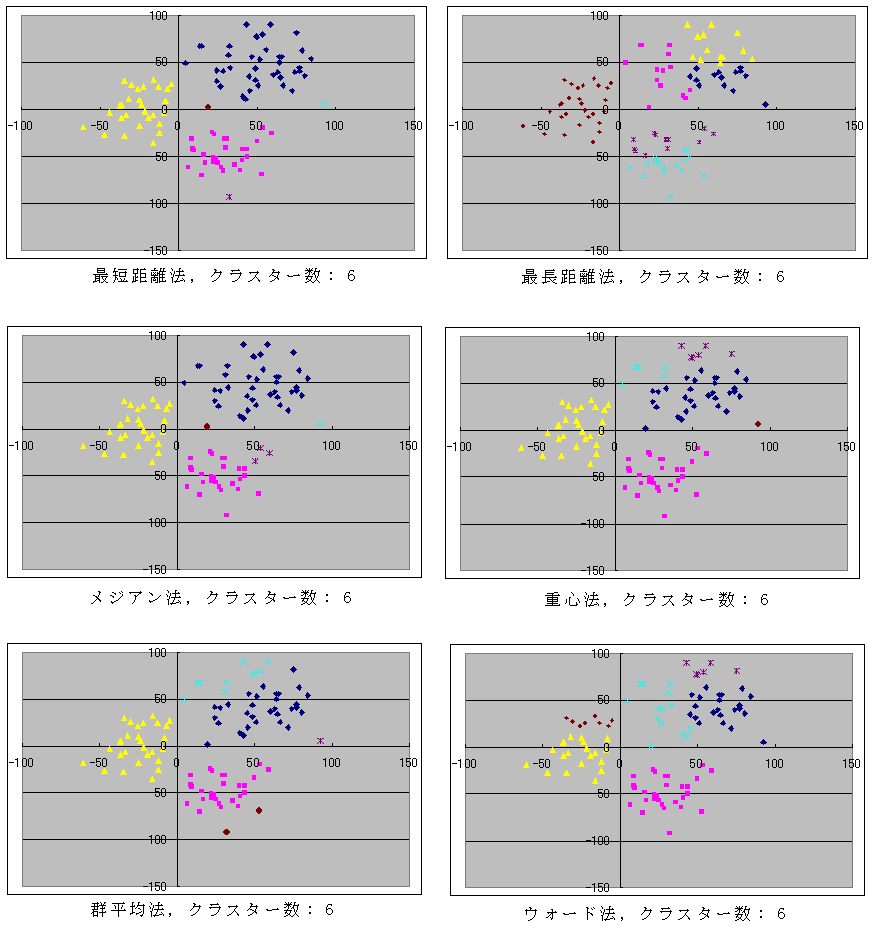
類似した対象をグループ化するクラスター分析では、個体数が少ない(数百件程度)場合は「階層型(hclust)」、大規模データの場合は「非階層型(kmeans)」を選択します。
# 距離行列の計算とウォード法による階層型クラスタリング dist_mat <- dist(scale(df_clean %>% select(where(is.numeric)))) hc <- hclust(dist_mat, method ="ward.D2") # 樹形図(デンドログラム)のプロット plot(hc, labels = FALSE, hang = -1, main ="デンドログラム") rect.hclust(hc, k = 4, border ="red") # 4クラスターに分割 # 非階層型(k-means)の実行 set.seed(123) km <- kmeans(scale(df_clean %>% select(where(is.numeric))), centers = 4) table(km$cluster) 【実態検証】現場でつまずくエラーの真相と結果の正しい解釈方法
オープンソースコミュニティや実務現場の生の声(Stack OverflowやQiita等で日常的に報告されるトラブル)を検証すると、初心者が直面するエラーの8割以上はデータ構造の不備に起因しています。
1. 「system is computationally singular」エラーの真相
回帰分析や因子分析の実行時に出現する「特異行列(Singular matrix)」エラーは、説明変数間に完全な線形従属が存在する場合(例:男性フラグと女性フラグの双方を同時に投入している、全合計値の列を構成要素と一緒に投入しているなど)に発生します。対処法として相関が1.0となる変数を片方除外します。
2. p値ハッキングと「統計的に有意」の落とし穴
サンプルサイズが数万件を超えるビッグデータの場合、極めて微小な差異であってもp値が0.0001以下(有意)と算出されてしまいます。p値が小さいことと、ビジネス上の効果量(実質的なインパクト)が大きいことは同義ではありません。必ず偏回帰係数やオッズ比の実数値、信頼区間の幅を併せて評価する必要があります。
3. 前処理におけるデータリーク
予測モデルを構築する際、訓練データとテストデータに分割する前に全体でscale()(標準化)をかけてしまうミスが多発しています。テストデータの情報が訓練データに漏洩(データリーク)すると、評価時の精度が見かけ上高くなり、実務運用時に著しく精度が低下する原因となります。
【プロの結論】初学者が挫折しないための学習ロードマップとおすすめ書籍
データ解析の現場で自走できるようになるためには、プログラミング構文と数理的直感のバランスが不可欠です。向き・不向きの基準と、最短で実務レベルに到達するための学習ロードマップを整理します。
Rによる多変量解析に向いている人・慎重になるべき人の判断基準
- Rの活用が最適な人:
- 学術論文や治験、マーケティングリサーチなど、厳密な統計的検定と再現性のあるレポート出力を重視する人。
- 数行の簡潔なコードで高度な統計モデリングやグラフィック作成(ggplot2)を完結させたい人。
- Python等を検討すべき人:
- 深層学習(ディープラーニング)や大規模言語モデル(LLM)の実装・システム組込を主眼に置く人。
- Webアプリケーションのバックエンドとして解析ロジックを直接デプロイする必要があるエンジニア。
多変量解析 おすすめ本 勉強法(2026年最新基準)
独学で進める際は、理論書とR実装書を1冊ずつ並行して読み進めるアプローチが最も挫折を防ぎます。
- 基礎理論・直感理解:『多変量解析法入門』(永田靖・棟近雅彦 著)— 数式の展開が丁寧で、各手法の幾何学的イメージが掴みやすい名著。
- R実践・データ操作:『Rではじめるデータサイエンス』(Hadley Wickham 著)— tidyverseの基本設計とデータハンドリングの作法を完全網羅。
- 統計モデリング応用:『データ解析のための統計モデリング入門』(久保拓弥 著)— 一般化線形モデル(GLM)の考え方を平易に解説した必読書。
【多変量解析×R】に関するよくある質問(FAQ)
Q1:統計学の高度な数学(線形代数や微積分)が苦手でもRで多変量解析はできますか?
A1:実務レベルでの運用であれば、厳密な手計算ができなくても問題ありません。ただし「分散・共分散」「相関係数」「固有値」「正規分布」の基本概念と、各手法が出力する指標(p値、決定係数、因子負荷量など)の意味を正確に理解しておくことは必須です。
Q2:多変量解析を実行するために必要なサンプルサイズ(データ件数)はどのくらいですか?
A2:手法や説明変数の数によりますが、一般的な経験則(Rule of Thumb)として、重回帰分析では説明変数の数の10〜20倍以上のサンプル数が推奨されます。因子分析では最低でも100〜200サンプル以上、かつ変数の数の5倍以上が安定した推定の目安となります。
Q3:RとPythonのどちらで多変量解析を学ぶべきでしょうか?
A3:統計解析・要約・レポート作成・アンケート分析が主目的であれば、統計処理に特化した標準関数やpsych、carなどのパッケージが充実しているR言語の方が短期間で高品質なアウトプットを出せます。一方、機械学習の自動化パイプラインやWebサービス連携を目指す場合はPythonが有利です。
まとめ:データから価値を引き出す再現性の高い分析基盤の構築へ
多変量解析は、一見複雑に見えるデータ群からノイズを取り除き、背後に潜む因果や構造をクリアに描き出すための極めて強力な武器です。そしてR言語は、その統計的アプローチを最もエレガントに具現化できるプラットフォームであり続けています。
コードを機械的に実行するだけでなく、「なぜこの手法を選ぶのか」「前提条件(正規性・多重共線性など)は満たされているか」「分析結果は現場のドメイン知識と整合しているか」を常に意識することが重要です。本稿で紹介したスクリプトと前処理の作法を足がかりに、ぜひ自前のデータを用いた実践解析に取り組んでみてください。 (出典: 多 変量 解析 r(Yahoo!ニュース))
毎日更新されるトレンド情報を分析・発信中。役立つ裏技やおすすめ情報を分かりやすく紹介します。
