量的データの具体例一覧|質的データとの違いや見分け方を徹底解説
ビジネスの現場や学術研究、日々の業務改善において「データを分析して意思決定を行う」重要性は高まり続けています。しかし、手元にあるデータが「量的データ」なのか「質的データ」なのかを正しく把握できていなければ、算出する平均値が無意味になったり、不適切なグラフを選んで誤った意思決定を招くリスクがあります。
数値として記録されているからといって、すべてが計算可能なデータとは限りません。本稿では、統計学の基礎となる量的データの具体例一覧から、質的データとの明確な境界線、実務で迷いがちな「離散データ・連続データ」「間隔尺度・比例尺度」の分類基準まで、現場目線で分かりやすく解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:量的データとは「数値として意味を持ち、足し算や引き算、平均値の算出ができるデータ」であり、身長・体重・売上・アクセス数などが該当する。
- 要点2:郵便番号や社員番号のように「数字であっても計算に意味がないもの」は質的データ(名義尺度)に分類されるため見分け方に注意が必要。
- 要点3:データ型を「離散・連続」「間隔・比例」の尺度レベルで正確に見極めることで、ヒストグラムや箱ひげ図など最適なグラフ選択と統計解析が可能になる。
【具体例一覧】量的データとは?数値で測定できる身近な変数総まとめ
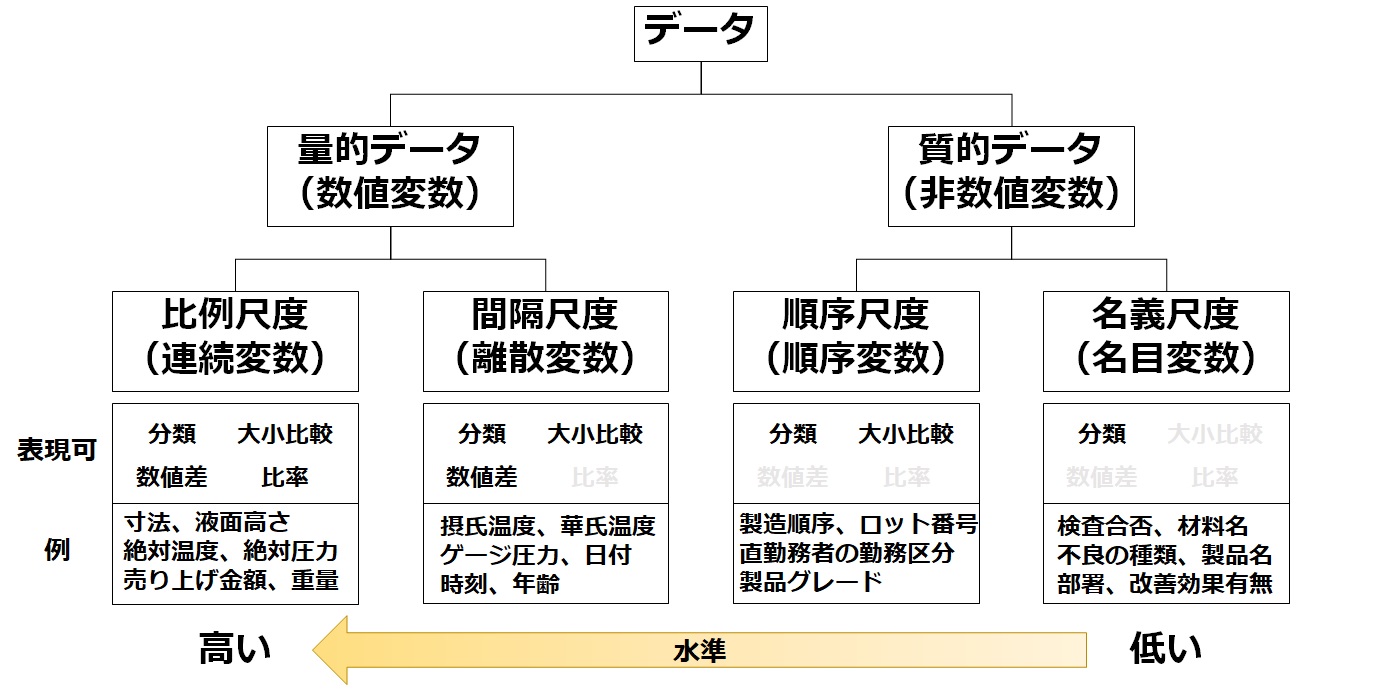
統計学における量的データ(量的変数)とは、対象の「量」や「大きさ」を数値で表したデータを指します。最大の特徴は、値同士の差や比率を計算でき、「平均値を求めることに意味がある」という点にあります。
量的データは、取り得る値の性質によって大きく「離散データ」と「連続データ」の2種類に分類されます。それぞれの身近な具体例を整理しました。
1. 離散データ(飛び飛びの値をとるデータ)の具体例
離散データとは、カウント(個数や回数)のように1つ、2つと整数で数えられるデータです。小数点以下の値が存在しない、あるいは決まった刻み幅しか取らない数値が該当します。
- WebサイトのPV数・UU数:月間100万PV、新規訪問者数など
- 店舗の来客数・成約件数:1日あたりの来店客数(人)、日別契約数(件)
- 世帯人数・子供の数:3人家族、子供2人など(「2.5人」のような実体は存在しない)
- 不良品の発生個数:製造ラインで検知されたエラー数(個)
- SNSの投稿シェア数・いいね数:リツイート数、フォロワー増減数
2. 連続データ(連続した切れ目のない値をとるデータ)の具体例
連続データとは、測定器を用いて測るような連続する実数値をとるデータです。測定の精度を上げれば、小数点以下どこまでも細かく計測できる特徴を持ちます。
- 身体測定値:身長(172.5cm)、体重(65.3kg)、体脂肪率(18.2%)
- 物理・気象指標:気温(24.8℃)、降水量(12.5mm)、気圧(1013.25hPa)
- 時間・期間:Webページの滞在時間(45.8秒)、作業所要時間、通勤時間
- 財務・経済指標:商品の価格(1,980円)、売上金額、株価、年間所得
- 走行距離・速度:自動車の燃費(21.4km/L)、移動速度(時速60km)
【決定的な違い】質的データと量的データを見分ける2つの判断基準
データ分析の初期段階で最も多い混乱が、「質的データ(質的変数)」と「量的データ(量的変数)」の混同です。質的データとは、数値ではなく「状態・カテゴリー・属性・順位」を表すデータを指します。
手元にある変数がどちらに属するか判断に迷った際は、次の2つの判定テストを適用すると瞬時に見分けることができます。
判定基準1:そのデータ同士で「引き算(差)」を計算して意味があるか?
例えば、Aさんの身長が180cm、Bさんが160cmの場合、「180 - 160 = 20cmの差がある」と解釈できます。これは引き算に明確な意味があるため量的データです。一方、会員ランク「ゴールド(3)」と「ブロンズ(1)」の引き算「3 - 1 = 2」には、物理的な「2」の差としての実質的な意味はありません。この場合は質的データです。
判定基準2:全体の「平均値」を算出して実態を表せるか?
データ群の合計をサンプル数で割った「平均値」が実体を持つ情報になるかを確認します。売上金額やテストの点数の平均値は直感的に状況を把握する指標になります。しかし、回答者の「性別(男性=1、女性=2)」の数値を足して割った「平均値1.5」には数学的な情報価値がありません。したがって性別は質的データです。
【徹底比較】4つの尺度と代表的なデータの分類一覧表
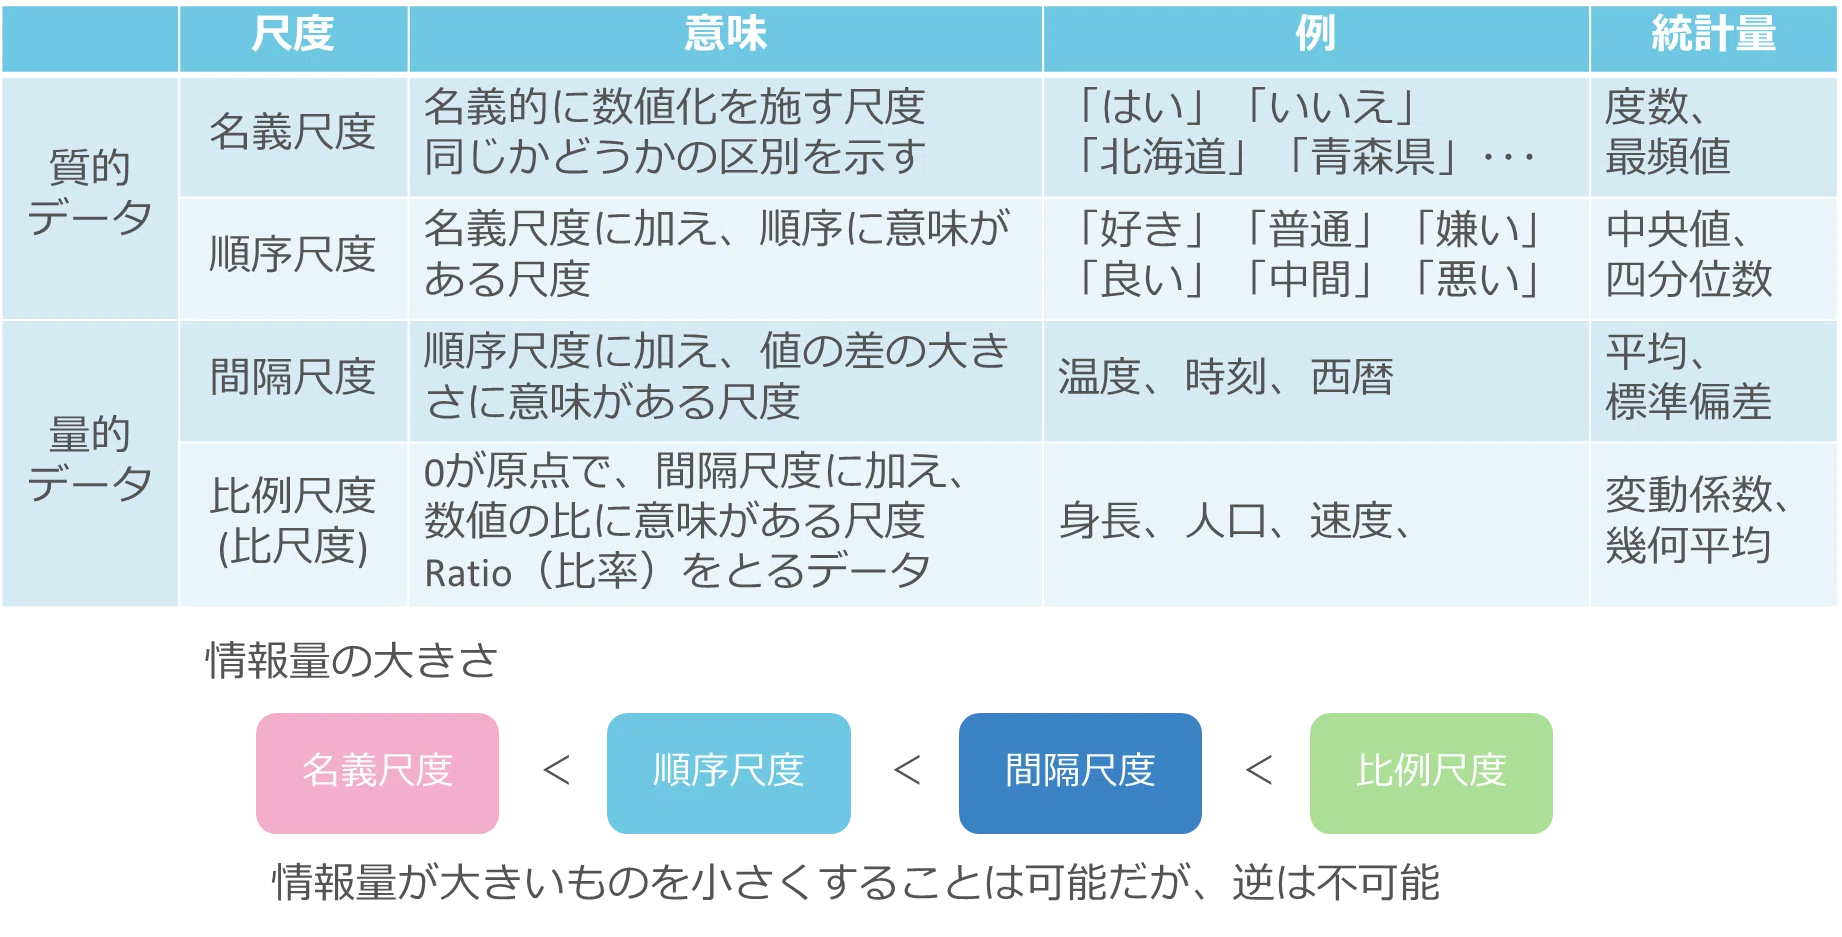
統計学では、データを情報の解像度に応じて「名義尺度」「順序尺度」「間隔尺度」「比例尺度(比率尺度)」の4階層に分類します。量的データに該当するのは「間隔尺度」と「比例尺度」の2つです。
| 尺度分類 | データの種類 | 可能な計算操作 | 代表的な具体例 |
|---|---|---|---|
| 名義尺度 | 質的データ | 分類・等しいか否か(=、≠) | 血液型、性別、郵便番号、社員番号 |
| 順序尺度 | 質的データ | 順序・大小関係(>、<) | 満足度(5段階)、順位、痛みの度合い |
| 間隔尺度 | 量的データ | 差の計算(+、-) | 摂氏気温(℃)、西暦年、偏差値、知能指数 |
| 比例尺度(比率尺度) | 量的データ | すべての四則演算(+、-、×、÷) | 身長、体重、売上高、滞在時間、絶対温度 |
間隔尺度と比例尺度の決定的な違いは、「絶対的な原点(絶対零点)」が存在するかどうかです。
例えば「気温0℃」は「熱が完全にゼロ」を意味するわけではなく、人間が決めた便宜上の基準点に過ぎません。そのため、「20℃は10℃の2倍暑い」という掛け算・割り算は成立しません(間隔尺度)。一方で、「体重0kg」は質量が全くない無の状態を示します。体重60kgの人は30kgの人の「正確に2倍の重さ」と言えるため、四則演算がすべて成り立つ比例尺度になります。

【実態検証】アンケート集約やビジネス分析で起きる致命的な落とし穴
マーケティング調査や社内アンケートの分析現場では、データの尺度を誤認したまま処理を進め、間違った結論を導き出してしまうトラブルが後を絶ちません。現場で頻発する2大トラップを検証します。
1. アンケートの「5段階評価」を安易に平均化するリスク
「大変満足(5)」「満足(4)」「普通(3)」「不満(2)」「大変不満(1)」といったリッカート尺度のアンケートデータは、本来「順序尺度(質的データ)」です。「大変満足」と「満足」の間隔と、「満足」と「普通」の間隔が等しい保証はどこにもありません。
実務では便宜上、スコア化して平均値を出すケースが一般化していますが、極端な不満層の存在が埋没しやすい欠点があります。厳密な分析を行う場合は、平均値だけでなく「中央値(メディアン)」や「最頻値(モード)」を算出し、各回答比率の分布(度数分布)を並行して確認することが統計的セオリーです。
2. 外れ値に引っ張られる「平均値の罠」
量的データを要約する際、条件反射で平均値だけを採用すると実態を見誤ります。代表例が「顧客単価」や「世帯年収」の集計です。
例えば、10人中9人が年収400万円で、1人だけ年収1億円の役員が含まれていた場合、平均年収は「1,360万円」に跳ね上がります。この数値を基に「このグループの平均像は年収1,300万円台」と判断すると、施策設計を大きく誤ります。データに極端な外れ値や歪み(偏り)がある場合は、中央値を代表値として採用するのが鉄則です。
一般に知られていない盲点|「数字=量的データ」の罠
「画面に数字が表示されているから、これは量的データに違いない」という思い込みは、データハンドリングにおける最大の盲点です。
典型的な例が、顧客ID、電話番号、郵便番号、クレジットカード番号などの管理用コードです。これらは便宜上アラビア数字で表記されているだけで、実質的には個々の識別やエリア分けを行う「記号(名義尺度)」に過ぎません。
顧客ID「10020」と「10010」を足して2で割っても何の意味も持ちません。機械学習モデルの構築やデータベース設計において、これらID変数を誤って量的変数として数値演算に組み込んでしまうと、モデルに無意味なノイズを与え、予測精度を著しく低下させる要因となります。
【可視化と解析】量的データに最適なグラフ種類と基本分析手法
量的データを分析・可視化する際は、データの分布や関係性を正しく表現できるグラフを選ぶ必要があります。質的データで多用される「円グラフ」や「棒グラフ(単純度数)」とは異なるアプローチが求められます。
| グラフの種類 | 分析目的・用途 | 適した量的データ例 |
|---|---|---|
| ヒストグラム | データのばらつき・度数分布の把握 | テストの点数分布、社員の残業時間分布 |
| 箱ひげ図 | 複数グループ間のばらつき・四分位数比較 | 店舗別の売上高比較、年代別の購入金額 |
| 散布図 | 2つの量的変数間の相関関係の検証 | 「広告宣伝費」と「商品売上高」の関係 |
| 折れ線グラフ | 時系列での連続的な推移・トレンド分析 | 日次売上推移、月別アクティブユーザー推移 |
量的データの代表的な分析手法
量的データを扱う場合、基礎統計量の確認から高度な推測統計まで多角的なアプローチが可能です。
- 基本統計量の算出:平均値、中央値、標準偏差、分散、四分位範囲を用いてデータの広がりと中心を捉える。
- 相関分析:ピアソンの積率相関係数を算出し、2変数間の直線的な関係の強さを数値化する(例:気温とアイスの売上)。
- 回帰分析:要因となる変数(説明変数)から結果となる変数(目的変数)を予測する数式モデルを構築する(例:広告費から将来の売上を予測)。
- t検定・分散分析:グループ間で平均値に統計的な有意差があるかを検証する(例:新旧Webデザイン間での滞在時間の有意差検定)。
【プロの結論】データサイエンス現場から学ぶ正しい分析判断基準
データ活用を成功させるための判断基準はシンプルです。「そのデータ型で可能な統計処理の限界線を知り、目的外の計算を強制しないこと」に尽きます。
データを取り扱う際は、必ず以下のフローで分類を確認してください。
- ステップ1:まず「平均値に実質的な意味があるか」を問い、質的データか量的データかを切り分ける。
- ステップ2:量的データであれば「数えられるもの(離散)」か「測るもの(連続)」かを特定する。
- ステップ3:原点ゼロに意味があるかを確認し、間隔尺度か比例尺度かを判断した上で、採用する統計量(平均値か中央値か)と可視化グラフを決定する。
この3ステップをチーム内でルール化するだけで、集計ミスや無根拠なグラフ作成によるミスリードを防止できます。
【量的データの具体例】に関するよくある質問(FAQ)
Q1:年齢は量的データですか?それとも質的データですか?
A1:取得形式によって異なります。「34歳」「42歳」のように実数値として記録している場合は連続データ・比例尺度(量的データ)です。一方、アンケートなどで「20代」「30代」「40代」のように年代区分で回答させている場合は、カテゴリー分けされた順序尺度(質的データ)として扱われます。
Q2:テストの点数や偏差値はどの尺度に該当しますか?
A2:100点満点のテストの点数は「0点=得点が皆無」という原点が存在するため比例尺度(量的データ)です。一方、偏差値は平均を50として相対的な位置を示す便宜上の指標であり、0が「能力ゼロ」を意味しないため間隔尺度(量的データ)に分類されます。
Q3:なぜ質的データを量的データのように平均化してはいけないのですか?
A3:間隔が均等でないデータ(順序尺度など)を単純に平均化すると、実態と乖離した歪んだ結果が生じるためです。例えば顧客満足度で「5(非常に満足)」と「1(非常に不満)」が半々の場合、平均値は「3(普通)」になりますが、「顧客全員が普通と感じている」わけではなく、実態は「評価が極端に二極化している」状態です。尺度を無視した計算は本質的な課題を見落とす原因になります。
まとめ:データの本質を見極めてビジネスと統計の成果を最大化する
量的データは、売上改善、業務効率化、マーケティングのROI向上など、あらゆる意思決定の根拠となる強力な武器です。しかし、どれほど高度なBIツールやAI分析基盤を導入しても、投入するデータの「型」と「尺度」を取り違えていては正しい成果は得られません。
手元のデータが「離散」なのか「連続」なのか、そして「間隔尺度」なのか「比例尺度」なのかを正しく見極めること。この基本に立ち返ることが、データドリブンな意思決定を確かな成果へと繋げる第一歩となります。 (出典: 量 的 データ 例(Yahoo!ニュース))
毎日更新されるトレンド情報を分析・発信中。役立つ裏技やおすすめ情報を分かりやすく紹介します。
