コード化とカテゴリー化の違いとは?質的研究の進め方と具体例を徹底解説
質的研究や看護研究、ユーザーインタビュー分析において、収集した膨大な発話記録や記述データから意味を抽出する作業は、多くの分析者が最初につまずく難所です。とりわけ「コード化」と「カテゴリー化」の定義や境界線が曖昧なまま作業を進めてしまい、途中でデータの関連性を見失ったり、単なるテキストの要約で終わってしまったりするケースが後を絶ちません。
定性的な質的データ分析方法において、コード化は現象を分解して意味を見出す基礎工事であり、カテゴリー化はその意味同士を構造化して理論や知見へと昇華させる骨組みの構築に他なりません。本稿では、分析現場で実際に起きている課題やグラウンデッドセオリーアプローチなどの理論的枠組みを踏まえ、データの整理から概念化までの確実なステップをわかりやすく解き明かします。
📌 【この記事の重要ポイントまとめ】
- 要点1:コード化は発話記録から「最小限の意味単位」を切り出す作業であり、カテゴリー化はそれらの共通項を束ねて「上位概念」へ引き上げる作業である。
- 要点2:分析の破綻を防ぐには、事前の「定性データコーディング基準」の策定と、逐語録に忠実なオープンコーディング手順の遵守が不可欠。
- 要点3:KJ法やテキストマイニングとの性質の違いを理解し、研究目的や現場の実態に合わせた柔軟なアプローチの選択が成果を左右する。
コード化とカテゴリー化の決定的な違い|概念化プロセスの本質
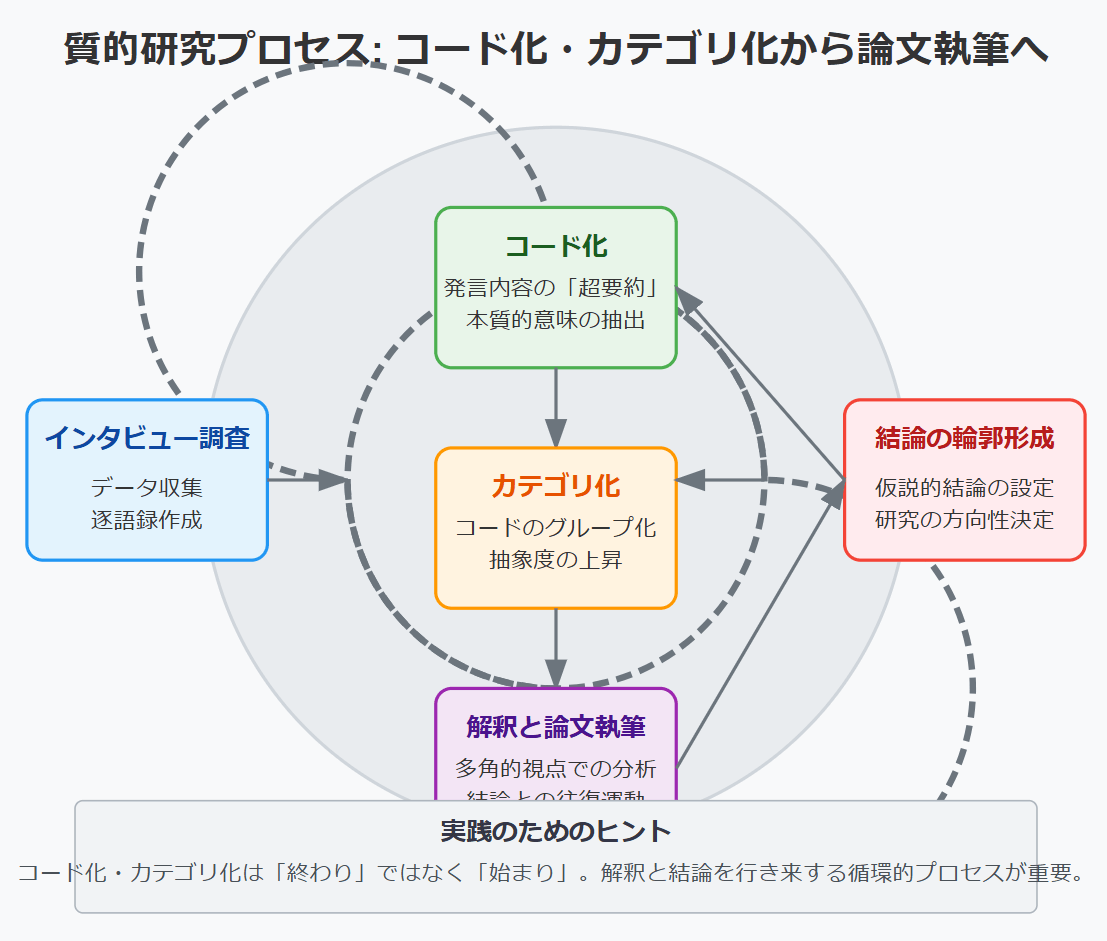
質的データの分析において、もっとも基本的でありながら混同されやすいのが「コード化(コーディング)」と「カテゴリー化」の役割です。この2つは独立した作業ではなく、概念化プロセス詳細における連続したフェーズとして捉える必要があります。
コード化とは、インタビュー調査分析などで得られた逐語録(トランスクリプト)や自由記述テキストを精読し、研究課題に関連する文脈や発言者の意図を損なわないよう配慮しながら、「意味の最小単位」として短い言葉やラベル(コード)に変換する作業を指します。元の文章から不要な修飾を削ぎ落とし、発言者が語っている現象の本質を言語化するプロセスです。
一方のカテゴリー化は、生成された無数のコードを比較・検討し、類似性や対立関係、因果関係に基づいてグループ化し、一段高い抽象度を持つラベル(カテゴリーおよびサブカテゴリー分類)を付与する作業です。コードが現象の断片であるのに対し、カテゴリーは現象同士の構造や文脈を説明するための概念的な枠組みとなります。
現場で分析が迷走する最大の原因は、コード化の段階でいきなり抽象的なまとめを行ってしまったり、カテゴリー化の段階で元のデータの文脈から乖離した主観的な解釈を当てはめてしまったりすることにあります。事実に基づいたコードから、徐々に抽象度を上げてカテゴリーへと統合していく「ボトムアップの思考」こそが、分析の妥当性を支える基盤となります。
【比較で納得】質的データ分析における各フェーズの定義と違い
分析の流れを視覚的に整理するために、元データから最終的な理論・概念化に至るまでの各ステップと、関連する手法の特徴を比較表にまとめました。
| 分析フェーズ | 詳細・具体的な作業内容 | 抽象度のレベル | 編集部の見解・分析の要点 |
|---|---|---|---|
| 元データ(逐語録) | インタビュー音声の文字起こし、フィールドノーツ、自由記述アンケート | 具体(事実そのもの) | 発言の背景やニュアンスを削らず、正確に可視化することが大前提。 |
| コード化(オープンコーディング) | 意味のある最小単位に分割し、現象を端的に表すラベルを付与 | 具体〜低位の抽象 | 要約ではなく「現象の本質」を捉えた命名(ネーミング)が鍵。 |
| サブカテゴリー分類 | 類似した文脈・意味を持つ複数のコードを集約し中位グループを形成 | 中位の抽象 | コード間の差異と共通性を丁寧に見極め、境界線を明確にする。 |
| メインカテゴリー化 | サブカテゴリー間の関係性を整理し、現象全体を説明する包括的概念を創出 | 高位の抽象(概念) | 他の研究者にも納得感のある論理的な構造化(概念化)が求められる。 |
| 理論・モデル構築 | カテゴリー間の因果関係や時系列をダイアグラム等で体系化 | 理論化・普遍化 | 実務や臨床現場へ応用可能な知見としての価値がここで確定する。 |
質的研究コード化手順とカテゴリー化の具体例|実践の全ステップ
実際の研究や実務において、どのような手順で作業を進めるべきかを具体的に解説します。ここでは看護研究コード化やり方やユーザーインタビューの現場で広く採用されている標準的な進め方をモデルとして提示します。
ステップ1:オープンコーディング手順とデータの精読
まず、対象者の発話テキストを何度も読み込み、文脈全体を把握します。その上で、対象者の感情や行動、判断の理由が表れている部分を特定します。この際、オープンコーディング手順に則り、既存の仮説や先入観を排除してデータその葉から立ち上がる意味を拾い上げることが重要です。
ステップ2:カテゴリー化具体例で見る変換プロセス
具体例として、若手看護師が「業務過多によるプレッシャー」を語ったインタビューの分析を見てみましょう。
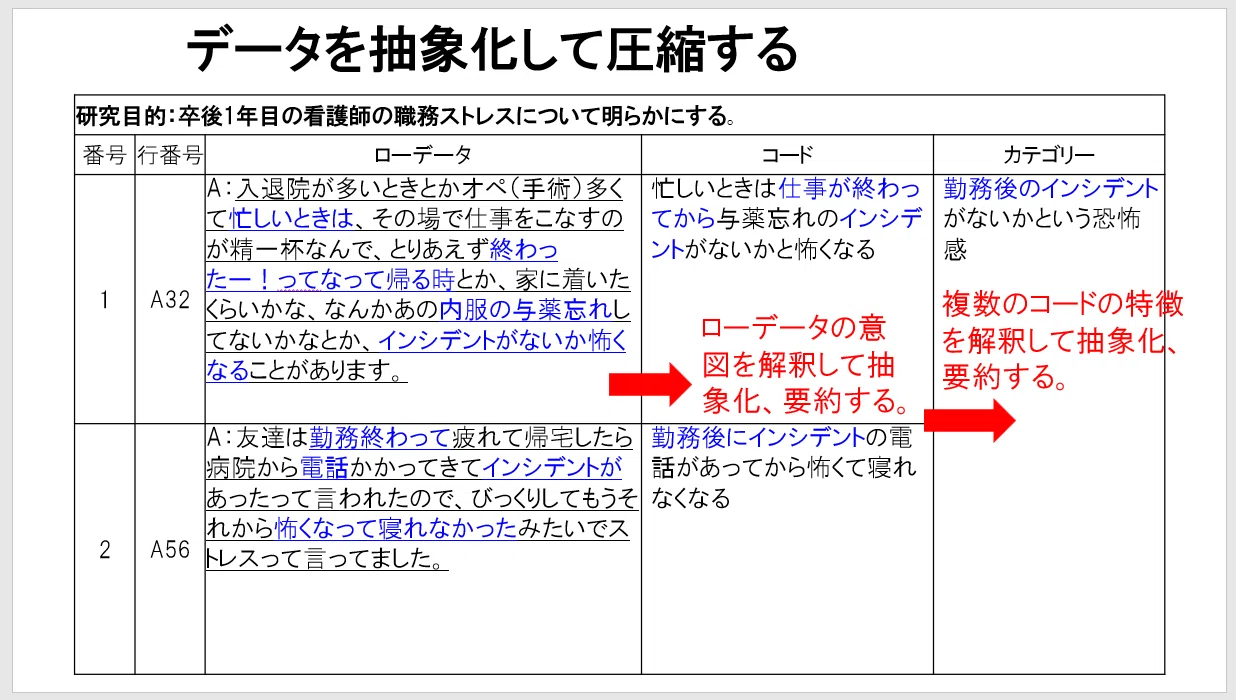
- 元データ(発話):「ナースコールが鳴り止まない中で先輩から急ぎの処置を頼まれると、優先順位がわからなくなって頭が真っ白になります。」
- 生成されたコード:「多重課題によるパニック状態の発生」「先輩からの指示と現場対応の板挟み」
- サブカテゴリー分類:これらに類似するコード(例:「引き継ぎ時の確認漏れへの恐怖」など)を集め、【同時並行業務における判断困難感】というサブカテゴリーを形成。
- メインカテゴリー化:さらに他のサブカテゴリー(例:【職場内の心理的安全性不足】など)と統合し、最終的に【多忙な臨床環境における認知過負荷と孤立】というメインカテゴリーへ昇華させます。
このように、カテゴリー化具体例を追っていくと、個別の出来事から徐々に人間関係や組織構造の課題へと視野が広がっていく構造が明確になります。
【実態検証】研究・調査現場のリアルな悩みと「分析が破綻する」原因
論文執筆や社内リサーチの現場では、テキスト分析に関して数多くの悲鳴が上がっています。大学院のゼミや医療機関の研究倫理委員会、SNS上の研究者コミュニティ等で報告される生の声を集約すると、つまずきのパターンは明確に類型化されます。
もっとも多く見られるのが、「コードの数が膨大になりすぎて収集がつかなくなる」という現象です。10名のインタビューから500個ものコードを作成したものの、それらをどう束ねればよいか分からず、作業が完全にストップしてしまうケースです。これは定性データコーディング基準が事前に明確化されていないために、研究課題と無関係な日常会話まで無差別にコード化してしまった結果生じます。
もう一つの典型例は、「最初から言いたい結論(仮説)が決まっており、それに合う発言だけを恣意的にカテゴリー化してしまう」という確証バイアスの罠です。これでは質的研究が本来持つ「データから新たな知見を発見する」という価値が失われ、査読者やステークホルダーから「定量的根拠のない単なる作文」と厳しく批判されることになります。
一般に知られていない盲点と誤解|KJ法やテキストマイニングとの違い
定性データの整理においては、手法同士の混同も頻繁に見受けられます。特にKJ法カテゴリー化違いや、近年の自然言語処理を用いたテキストマイニング定性分析との使い分けについて、正しい理解を持っておく必要があります。
川喜田二郎氏によって考案されたKJ法は、もともと「アイデア創出や問題解決のための発想法」として開発されたものです。カードを広げて直感的にグループ化する手法は質的分析と親和性が高いものの、学術研究における厳密なコーディングとは目的が異なります。KJ法は合意形成や発想の飛躍を重視するのに対し、グラウンデッドセオリーアプローチなどの質的分析は「データの網羅性と理論的飽和(これ以上新しい概念が出ない状態)」を厳格に追求します。
また、テキストマイニングツールによる頻出語の自動抽出は、データの全体像を大づかみに把握するには極めて有用です。しかし、形態素解析による単語のカウントは「言葉の出現頻度」を示すに過ぎず、発言者が込めた「文脈、皮肉、ためらい、沈黙の意図」といった深層の意味構造までは読み解けません。機械的な集計と、人間による文脈解釈を混同しない姿勢が求められます。

【プロの結論】失敗しないための判断基準と研究手法の選び方
質の高い定性分析を完遂するためには、自身の研究課題やリソースに最適なアプローチを選択する明確な判断基準が欠かせません。
【プロの結論】おすすめできる人・慎重になるべき人の判断基準
- グラウンデッドセオリー等の厳密なコード化が向いているケース:
- 未解明の心理プロセスや、人間関係の複雑な力学をボトムアップで解明したい場合
- 「なぜそのような行動をとるに至ったのか」という深い文脈(コンテクスト)を重視する研究
- 十分な分析時間と、複数人でのコード検証(ピア・レビュー)が可能な体制がある場合
- テキストマイニングや記述的枠組みの採用を検討すべきケース:
- 回答者数が数百〜数千件に及び、手作業での精読が物理的に不可能な場合
- 既にある程度確立された理論モデルがあり、その枠組みに沿って分類を行いたい場合
- 短納期のビジネスリサーチで、大まかな顧客ニーズの傾向を迅速に把握したい場合
質的データ分析の本質は、対象者の語りに徹底して寄り添いながらも、研究者自身が分析の論理的客観性を保つという「主観と客観の高度な往復運動」にあります。コード化とカテゴリー化はそのための羅針盤であり、手順を正しく踏むことで、データは単なる文字情報の集合から、誰にとっても価値ある生きた知見へと姿を変えます。
【コード化・カテゴリー化】に関するよくある質問(FAQ)
Q1:コード化する際、1つのコードの長さや粒度はどの程度が適切ですか?
A1:コードは「1つの完結した意味」を表す短いフレーズ(10文字〜30文字程度)が適切です。単語1語では文脈が抜け落ちてしまい、逆に数行の文章にしてしまうと単なる要約になってカテゴリー化が困難になります。「誰が・何に対して・どう感じたか」が第三者にも伝わる簡潔なラベル付けを意識してください。
Q2:看護研究などでカテゴリー化を行う際、指導教員や共同研究者と意見が割れたらどうすべきですか?
A2:質的研究において分析者間の解釈の不一致は自然な現象です。その場合は、元の逐語録(生データ)に立ち返り、「その解釈が文脈全体と整合しているか」を議論します。このプロセス自体を「ピア・デブリーフィング(共同討議)」として記録し、分析の妥当性を高めるプロセスの一部として論文に記載することが推奨されます。
Q3:AIツールやテキストマイニングだけでカテゴリー化を自動化できますか?
A3:AIツールによる予備的な分類や類似度判定は作業効率化に有効ですが、最終的なカテゴリーの命名や意味づけは人間の分析者が行う必要があります。質的研究の核心は「発言の背後にある暗黙の文脈や感情」の解釈にあるため、AIの出力を鵜呑みにせず、人間が確認・修正するハイブリッドな運用が現実的です。
まとめ:確実な分析手順でデータの価値を最大化する
コード化とカテゴリー化は、混沌とした定性データに秩序を与え、現象の核心を浮かび上がらせるための極めて論理的な作業です。コード化によって事実の意味を抽出し、サブカテゴリーからメインカテゴリーへと段階的に概念化を進めることで、どのような研究課題においても説得力のある結論を導くことが可能になります。
分析に行き詰まったときは、焦って抽象的な結論を急ぐのではなく、常に「元の生データ」と「コーディング基準」へと立ち返る勇気を持つことが、失敗しない質的研究への最短ルートとなります。 (出典: コード 化 カテゴリー 化(Yahoo!ニュース))
SEOライティングとマーケティング戦略の専門家。分かりやすい解説記事で定評があります。
