Heapqで比較するための特殊メソッド
ITエンジニアの登竜門である基本情報技術者試験をはじめ、データ圧縮技術の根幹として必ず名前が挙がる「ハフマン符号化」。テキストデータや画像ファイルを効率よく小さくするこの仕組みの中心にあるのが「ハフマン木」と呼ばれる特殊な二分木構造です。
「アルゴリズムの仕組みが難しそう」「頻出問題の計算式でいつも混乱する」という声も少なくありません。そこで本稿では、情報理論の基礎からハフマン木の具体的な構築手順、さらには平均符号長や圧縮率の計算方法まで、図解を交えながら直感的に理解できるように徹底解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:ハフマン木は「出現頻度が高い文字に短い符号、低い文字に長い符号」を割り当てる可逆圧縮アルゴリズムの中核を担う。
- 要点2:作り方の鉄則は「出現頻度が最も小さい2つのノードを選んで結合し、親ノードに合計値を設定する」操作をルートが1つになるまで繰り返すこと。
- 要点3:接頭辞が重ならない「プレフィックス符号」の性質を持つため、区切り文字がなくても瞬時に一意の復号ができる。
【基礎知識】ハフマン符号化の仕組みと可逆圧縮が重宝される理由
ハフマン符号化は、1952年にデビッド・ハフマン(David A. Huffman)によって考案された情報理論に基づく可逆圧縮手法です。元のデータを完全に復元できる可逆圧縮であり、ZIP形式の基盤となるDeflateアルゴリズムやJPEG画像の最終符号化段階など、現在も無数のシステムで活躍しています。
従来の固定長符号(例えばASCIIコードやUTF-8など)では、どの文字も等しいビット数(8ビットなど)で表現されます。しかし日常の文章やソースコードを見渡すと、アルファベットの「e」や「a」、日本語の「い」や「ん」のように圧倒的に出現頻度が高い文字が存在します。
ハフマン符号化では、よく使われる文字には「0」や「10」といった短いビット列を、滅多に使われない文字には「1110」といった長いビット列を割り振ります。これにより、全体のデータサイズを劇的に削ぎ落とすことが可能になります。
【5ステップ図解】ハフマン木の作り方と出現頻度からのノード結合手順
ハフマン木を構築するアルゴリズムは、貪欲法(Greedy Algorithm)を採用した極めて明快なプロセスです。具体例として、以下の文字列に出現する各文字の頻度をもとに、実際に木を組み立てていきましょう。
【対象データと文字の出現回数】
A:40回、B:20回、C:15回、D:15回、E:10回(合計100文字)
ステップ1:出現頻度の昇順(小さい順)に並べ替える
まずはすべての文字を独立したノード(葉)とし、出現頻度の昇順に並べます。
[E: 10] , [C: 15] , [D: 15] , [B: 20] , [A: 40]
ステップ2:最も頻度が小さい2つのノードを取り出して結合する
リストの先頭にある最も値の小さい「E (10)」と「C (15)」を取り出し、これらを子に持つ新しい親ノードを作成します。親ノードの値は2つの合計である「25」になります。
(25) / \ [E:10] [C:15]
ステップ3:新しい親ノードをリストに戻し、再びソートする
結合してできたノード(25)を元のリストに戻し、再度小さい順に整列します。
[D: 15] , [B: 20] , (25) , [A: 40]
ステップ4:ノードが1つ(根)になるまでステップ2と3を繰り返す
次に小さいのは「D (15)」と「B (20)」です。これを結合して親ノード「(35)」を作ります。
(35) / \ [D:15] [B:20]
リストは [(25), (35), [A: 40]] となります。続いて「(25)」と「(35)」を結合し、親ノード「(60)」を生成します。
(60) / \ (25) (35) / \ / \ [E:10] [C:15] [D:15] [B:20]
最後に残った「[A: 40]」と「(60)」を結合すると、合計値「(100)」を持つ根ノード(ルート)が完成します。
ステップ5:枝に「0」と「1」を割り振って符号を決定する
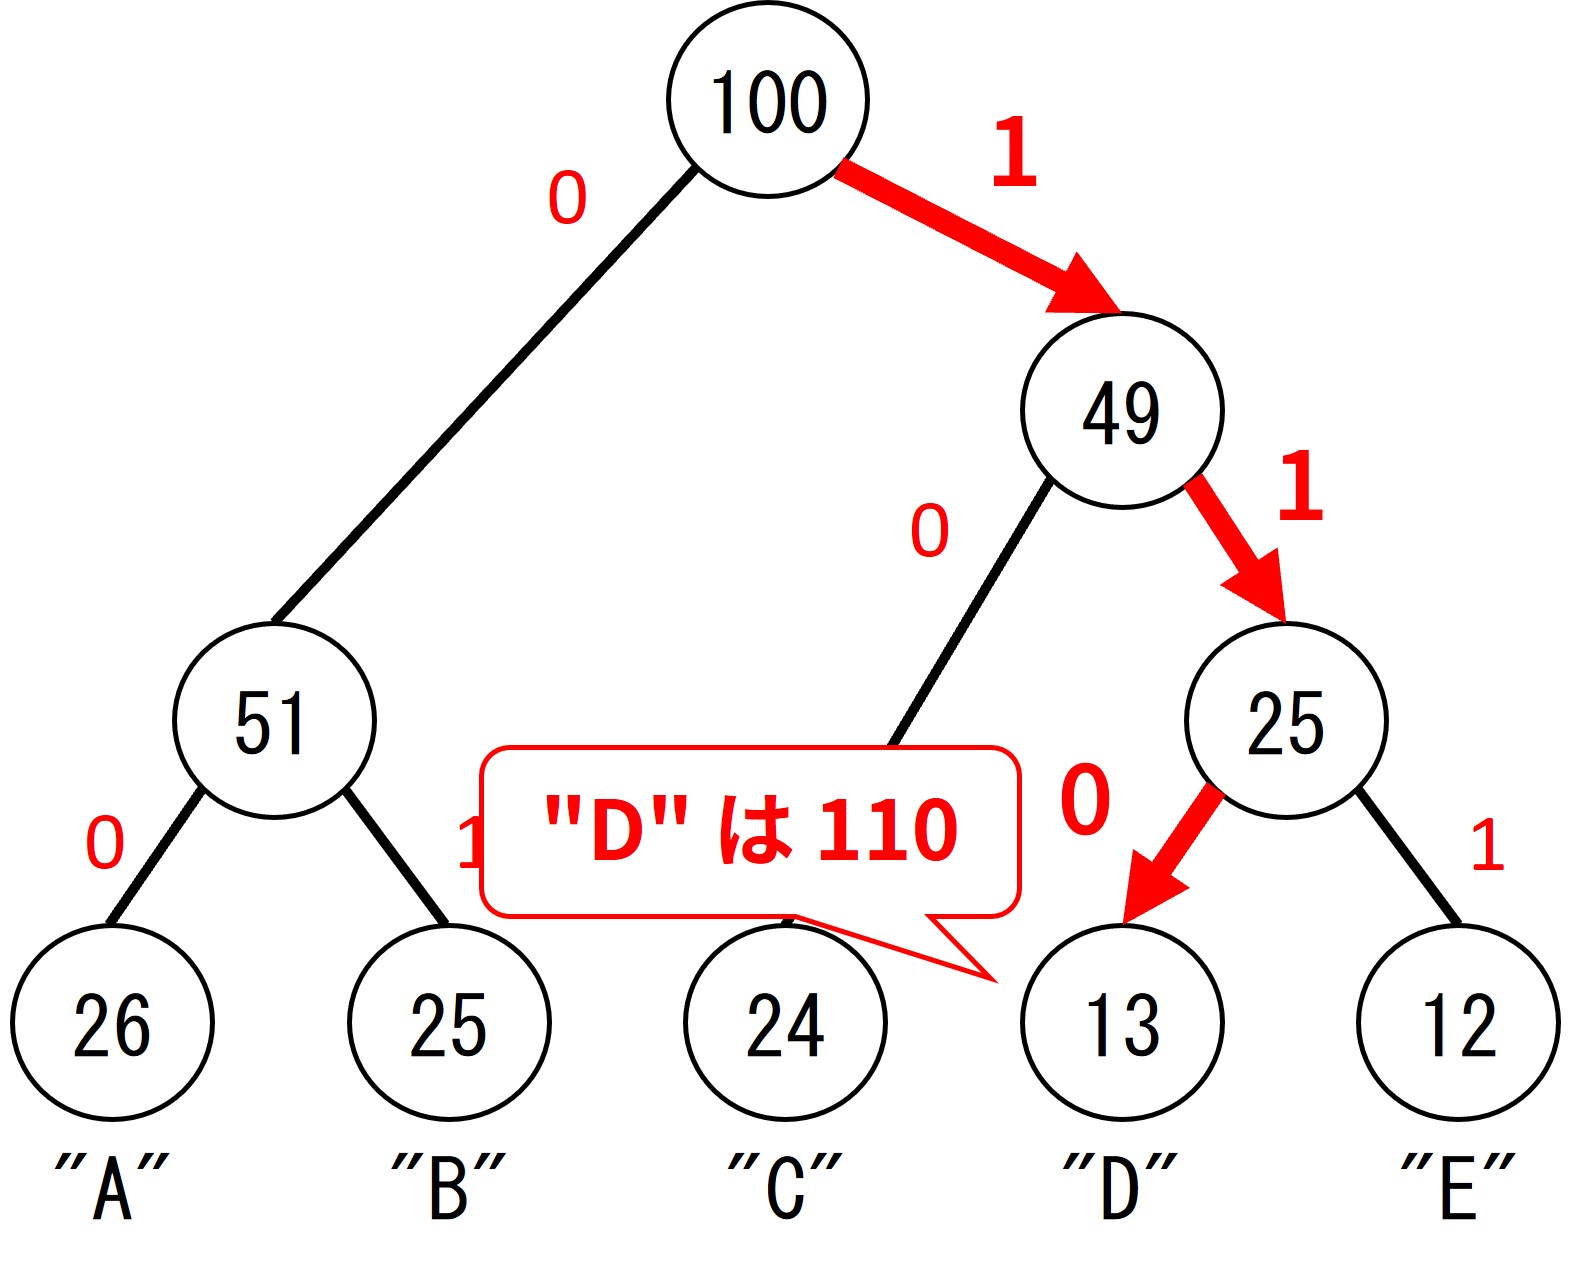
二分木全体に対し、左の枝に「0」、右の枝に「1」(逆でもルールが統一されていれば可)を割り当てます。
Root (100) / \ 0 / \ 1 [A:40] (60) / \ 0 / \ 1 (25) (35) / \ / \ 0 / 1 \0 / 1 \ [E:10] [C:15] [D:15] [B:20]
ルートから各文字の葉ノードまで辿った経路が、その文字の符号になります。
- A:
0(1ビット) - E:
100(3ビット) - C:
101(3ビット) - D:
110(3ビット) - B:
111(3ビット)
【基本情報対策】ハフマン木の計算問題の解き方と平均符号長・圧縮率の算出法
国家試験である基本情報技術者試験や応用情報技術者試験では、ハフマン木そのものの作図だけでなく、「平均符号長」と「圧縮率」の計算問題が定番として出題されます。確実に得点源にするための計算手順をマスターしましょう。
平均符号長の求め方
平均符号長とは、「1文字あたり平均何ビットで表現できているか」を示す数値です。各文字の「符号のビット数 × 出現割合(確率)」を合算して求めます。
先ほどの例(全体100文字)で計算してみましょう。
- A(40%):1ビット × 0.40 = 0.40ビット
- B(20%):3ビット × 0.20 = 0.60ビット
- C(15%):3ビット × 0.15 = 0.45ビット
- D(15%):3ビット × 0.15 = 0.45ビット
- E(10%):3ビット × 0.10 = 0.30ビット
これらをすべて足し合わせると、平均符号長 = 0.40 + 0.60 + 0.45 + 0.45 + 0.30 = 2.20ビット となります。
圧縮率の計算シミュレーション
もし5種類の文字を固定長ビットで表す場合、2の2乗(4通り)では足りないため、最低でも「1文字あたり3ビット」が必要です。元データ100文字のサイズは 3ビット × 100 = 300ビット になります。
一方、ハフマン符号化を適用した後のデータサイズは 2.20ビット × 100 = 220ビット です。これにより、約26.7%のデータ削減に成功したことが数値で明確に証明されます。
【復号手順と二分木】プレフィックス符号が持つ一意復号のからくり
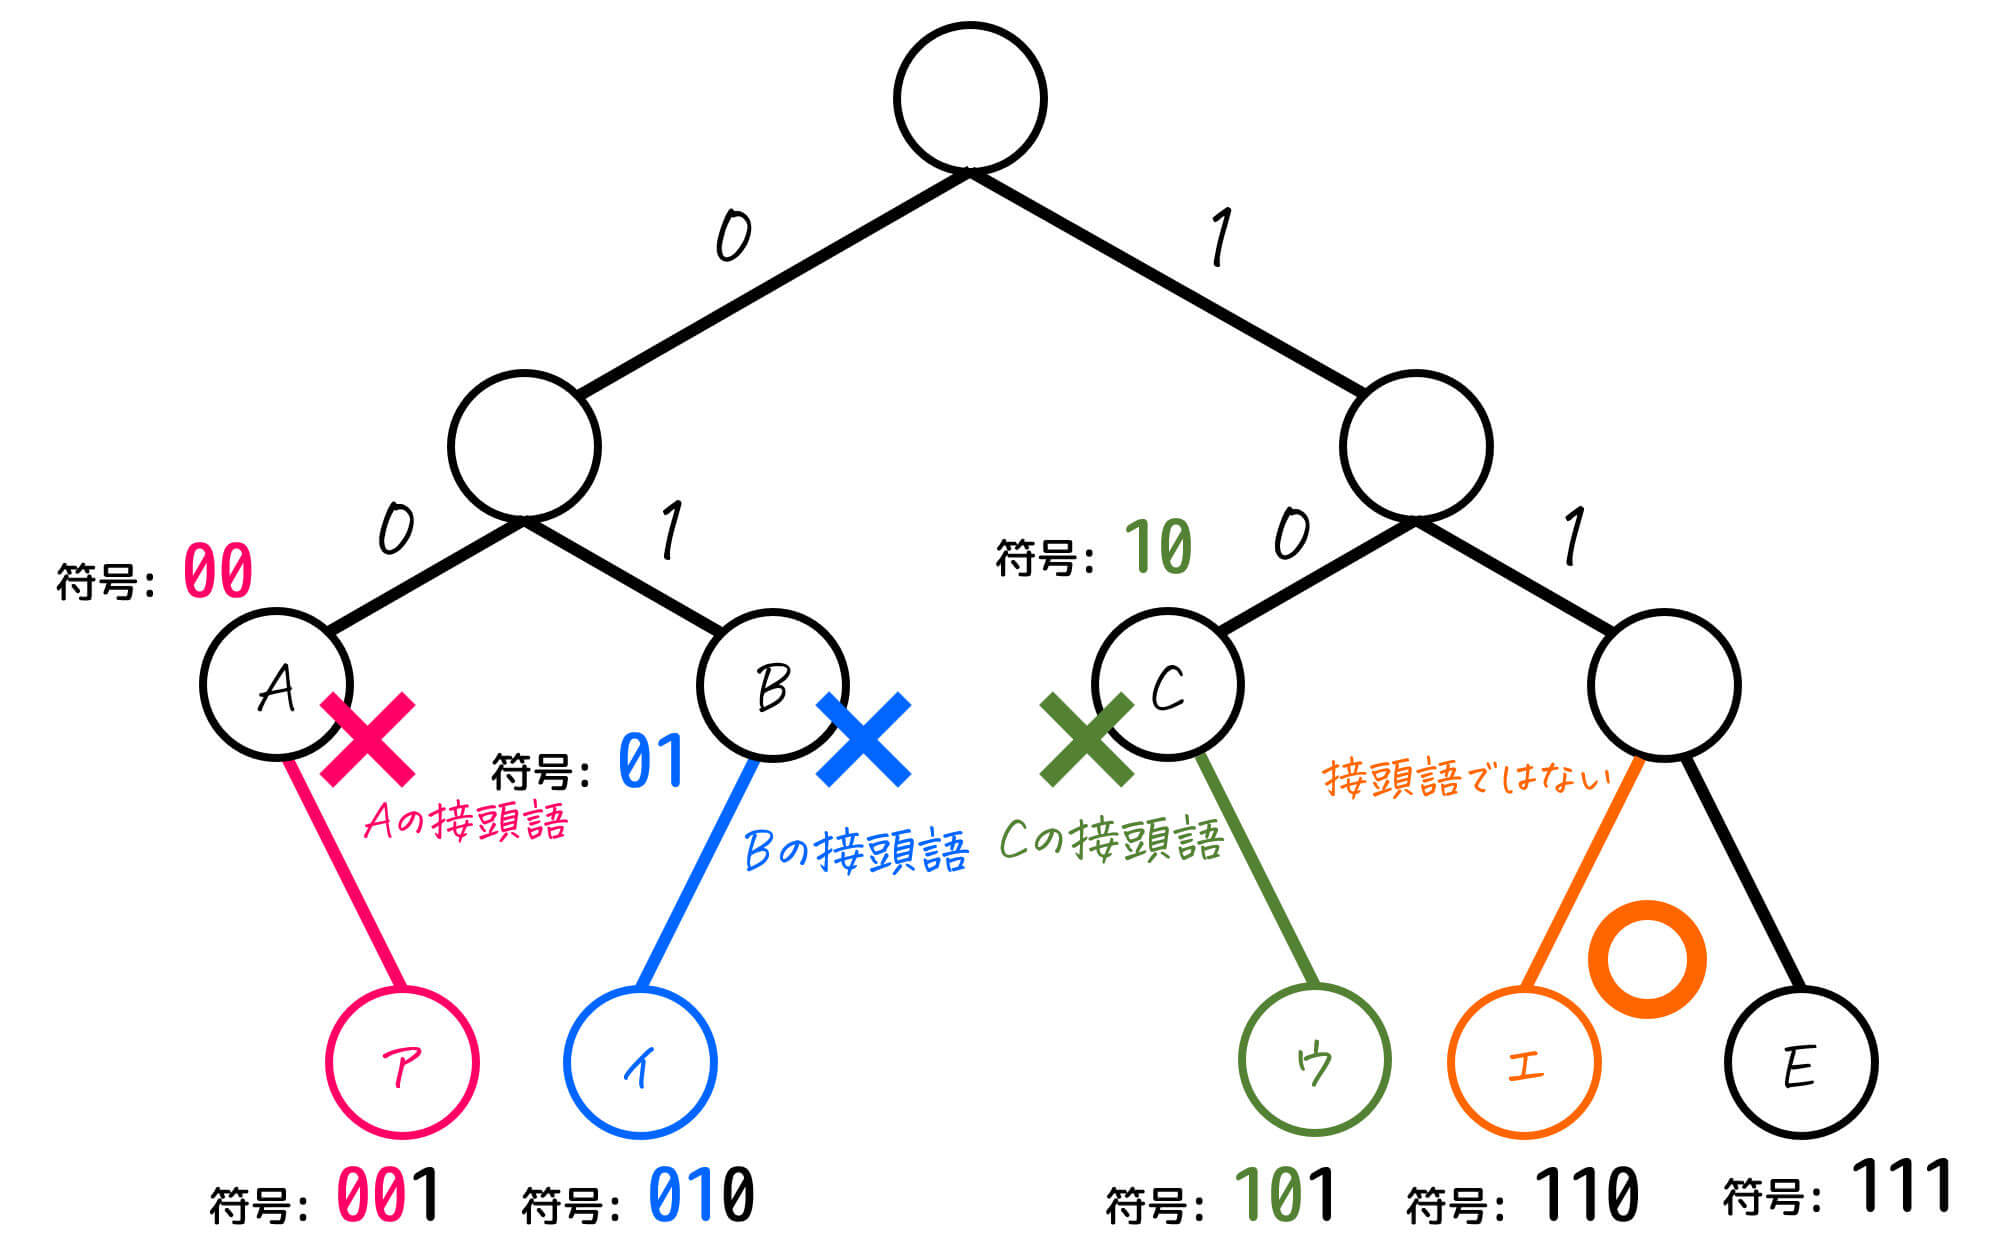
ハフマン符号の際立った特徴は、可変長符号でありながら文字と文字の間にカンマやスペースなどの区切り記号が一切不要である点です。これが実現できる理由は、ハフマン木によって生成されるビット列が「プレフィックス符号(接頭辞符号)」になるためです。
プレフィックス符号とは、「どの文字の符号も、他の文字の符号の先頭(プレフィックス)にならない」という性質を指します。ハフマン木ではすべての文字が木の「葉(末端)」にのみ配置され、途中の分岐ノードには文字が存在しないため、必ずこのルールが成立します。
ビット列の復号手順
たとえば受信したビット列が 0111100 だった場合、受信側はハフマン木をルートから1ビットずつ辿るだけで、瞬時に復号できます。
- 最初のビット
0を読む → ルートから左へ進むと直ちに葉「A」に到達。ここで1文字確定。 - ルートに戻り、次のビット
1,1,1を順に進む → 葉「B」に到達。2文字目確定。 - 再びルートに戻り、残りの
1,0,0を進む → 葉「E」に到達。3文字目確定。
結果として、元の文字列「ABE」が一意に正しく復元されます。曖昧さが一切生じないこのエレガントな復号手順こそ、二分木構造を採用した最大の強みです。
【実装編】優先度付きキューを活用したハフマン木のPython実装
ハフマン木のアルゴリズムをプログラムで実装する際、実務や競技プログラミングでは標準ライブラリの優先度付きキュー(heapqモジュール)を利用するのが最も定石かつ効率的です。最小値を $O(\log N)$ で高速に取り出せるため、大量のデータも一瞬で処理できます。
import heapq from collections import Counter class Node: def init(self, char, freq): self.char = char self.freq = freq self.left = None self.right = None def lt(self, other): return self.freq < other.freq def build_huffman_tree(text): # 出現頻度をカウント frequency = Counter(text) # ノードを作成してヒープに登録 heap = [Node(char, freq) for char, freq in frequency.items()] heapq.heapify(heap) # 1つの木になるまで結合を繰り返す while len(heap) > 1: node1 = heapq.heappop(heap) node2 = heapq.heappop(heap) merged = Node(None, node1.freq + node2.freq) merged.left = node1 merged.right = node2 heapq.heappush(heap, merged) return heap[0] def generate_codes(node, prefix="", code_map=None): if code_map is None: code_map = {} if node is not None: if node.char is not None: code_map[node.char] = prefix generate_codes(node.left, prefix + "0", code_map) generate_codes(node.right, prefix + "1", code_map) return code_map # 実行テスト text_data ="AAAAABBBCCDE" root = build_huffman_tree(text_data) huffman_codes = generate_codes(root) for char, code in sorted(huffman_codes.items()): print(f"文字: '{char}' => 符号: {code}") このように、最小ヒープ構造を使うことで、ステップ2・3の「最小ノードの結合と再整列」を無駄のない洗練されたコードで表現できます。
【応用例と実社会】ZIPやJPEGにも息づく情報理論の金字塔
ハフマン符号化は教科書の中の理論にとどまらず、私たちが日常的に利用しているデジタルインフラの至る所で現役で稼働しています。
- ZIP圧縮(Deflate):連続する文字列を辞書化する「LZ77」アルゴリズムで前処理を行った後、最終的なバイナリ圧縮にハフマン符号化が適用されています。
- JPEG画像圧縮:離散コサイン変換(DCT)と量子化を経てランレングス符号化された係数データに対し、最後にハフマン符号化を行ってファイルサイズを極小化しています。
- MP3オーディオ:人間の聴覚特性に基づき不要な音を削ぎ落とした周波数スペクトルデータを、ハフマン木を用いて効率よく符号化しています。
近年では、より理論限界に近い圧縮率を叩き出す「算術符号」や「ANS(Asymmetric Numeral Systems:Zstandardなどで採用)」に主役の座を譲る場面もありますが、実装の平易さと圧倒的なデコード速度のバランスにおいて、ハフマン符号化は今なお比類のない信頼性を誇っています。
【ハフマン木の作り方】に関するよくある質問(FAQ)
Q1:出現頻度が同じ文字が複数ある場合、どちらを左の子にすればいいですか?
A1:左右の割り当て順序や、同じ頻度を持つノードの結合順序に厳密な決まりはありません。どちらを優先しても「最短の平均符号長」という圧縮効率は完全に同一になります。ただし、試験問題などで指定がある場合は、問題文の指示(例:「同値の場合はアルファベット順」など)に従ってください。
Q2:ハフマン符号化のデメリットや弱点はありますか?
A2:主な弱点は2つあります。1つ目は、復号時に符号表(またはハフマン木そのもの)を受信側に渡す必要があるため、極端に短いテキストだとヘッダー情報のオーバーヘッドで逆にファイルサイズが増加する点。2つ目は、1文字あたりの割り当てビット数が必ず「1以上の整数」に制限されるため、シャノンの情報源エントロピー理論限界にわずかに届かない点です。
Q3:適応型(動的)ハフマン符号化とは何ですか?
A3:通常のハフマン符号化(静的)はデータを事前に全走査して頻度表を作りますが、適応型ハフマン符号化はデータを読み込みながらリアルタイムに木構造を逐次更新していく手法です。事前スキャンが不要なため、ネットワークストリーミング伝送などに適しています。
まとめ:アルゴリズムの思考プロセスを身につけてスキルを高めよう
ハフマン木の作り方は、「頻度の低いもの同士を束ねていく」という直観的でシンプルなルールに基づいています。しかしその背景には、プレフィックス符号による効率的な一意復号や、貪欲法が数学的に最適解を導き出す美しさなど、計算機科学の神髄が詰まっています。
基本情報技術者試験の対策としてはもちろん、データ構造やアルゴリズム設計の基礎体力を養う上でも、実際に手を動かして木を描き、平均符号長を計算してみることが何よりの近道です。ぜひ本稿の手順を参考に、圧縮アルゴリズムの本質をモノにしてください。 (出典: ハフマン 木 作り方(Yahoo!ニュース))
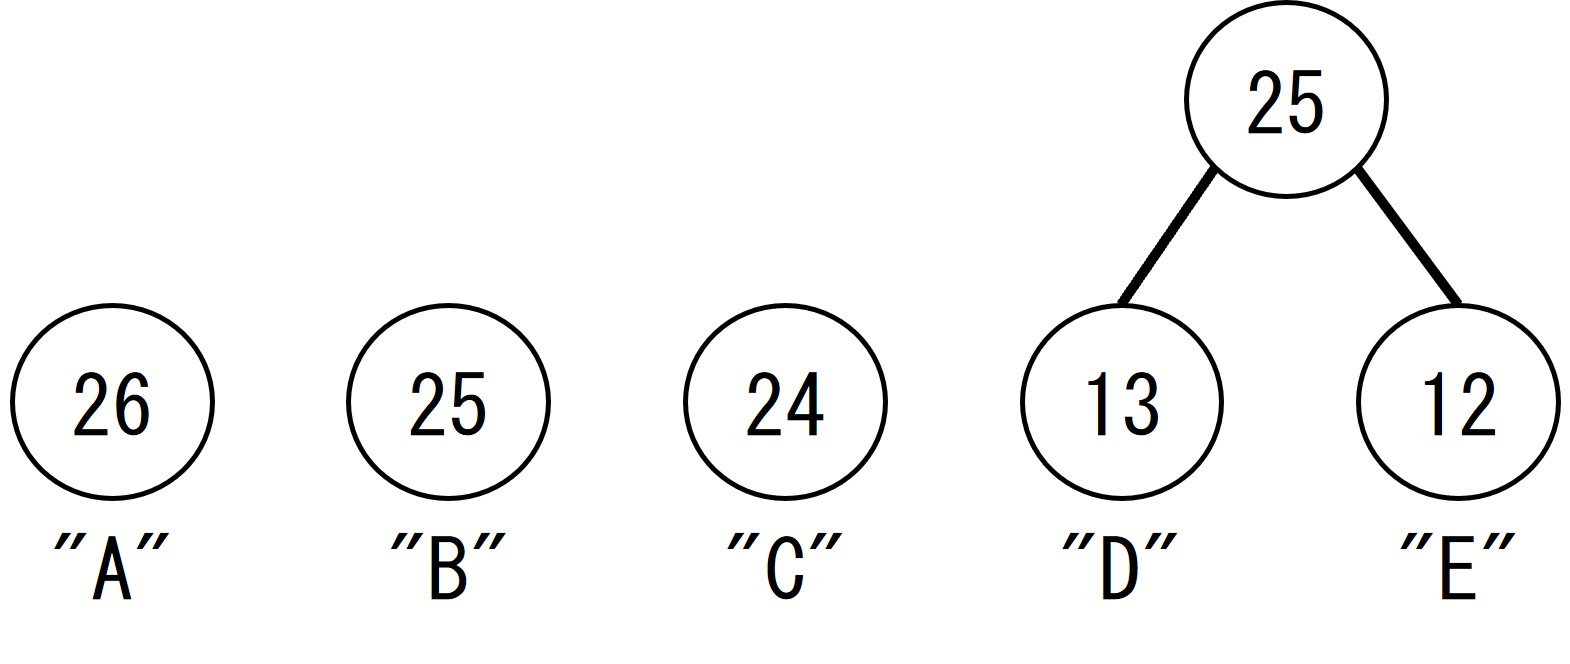
毎日更新されるトレンド情報を分析・発信中。役立つ裏技やおすすめ情報を分かりやすく紹介します。
