共分散と相関係数の違いとは?データ分析での求め方と落とし穴を解説
ビジネスの現場やマーケティング施策の効果検証において、2つのデータの連動性を正しく捉えるスキルは欠かせません。売上と広告費、気温と飲料の売上など、一見関係がありそうな数値群を読み解く第一歩となるのが「共分散」です。
しかし、実際の現場では「共分散の数値が出たものの、どう解釈すればいいかわからない」「相関係数と何が違うのか曖昧なまま使っている」という声も多く聞かれます。本稿では、共分散の本質的な意味から計算式の仕組み、ExcelやPythonを使った算出手順、実務で陥りがちな落とし穴までを整理してお伝えします。
📌 【この記事の重要ポイントまとめ】
- 要点1:共分散は「2つのデータの増減の向き(正の相関・負の相関)」を示す指標であり、符号で連動性が判断できる。
- 要点2:相関係数との決定的な違いは「単位依存の有無」にあり、共分散単体では関係性の強弱を比較できない。
- 要点3:ExcelのCOVARIANCE関数やPythonを使えば容易に算出できるが、外れ値や疑似相関への注意が必須となる。
【基本概念】共分散とは何か?分散と標準偏差から紐解くデータのバラつき指標
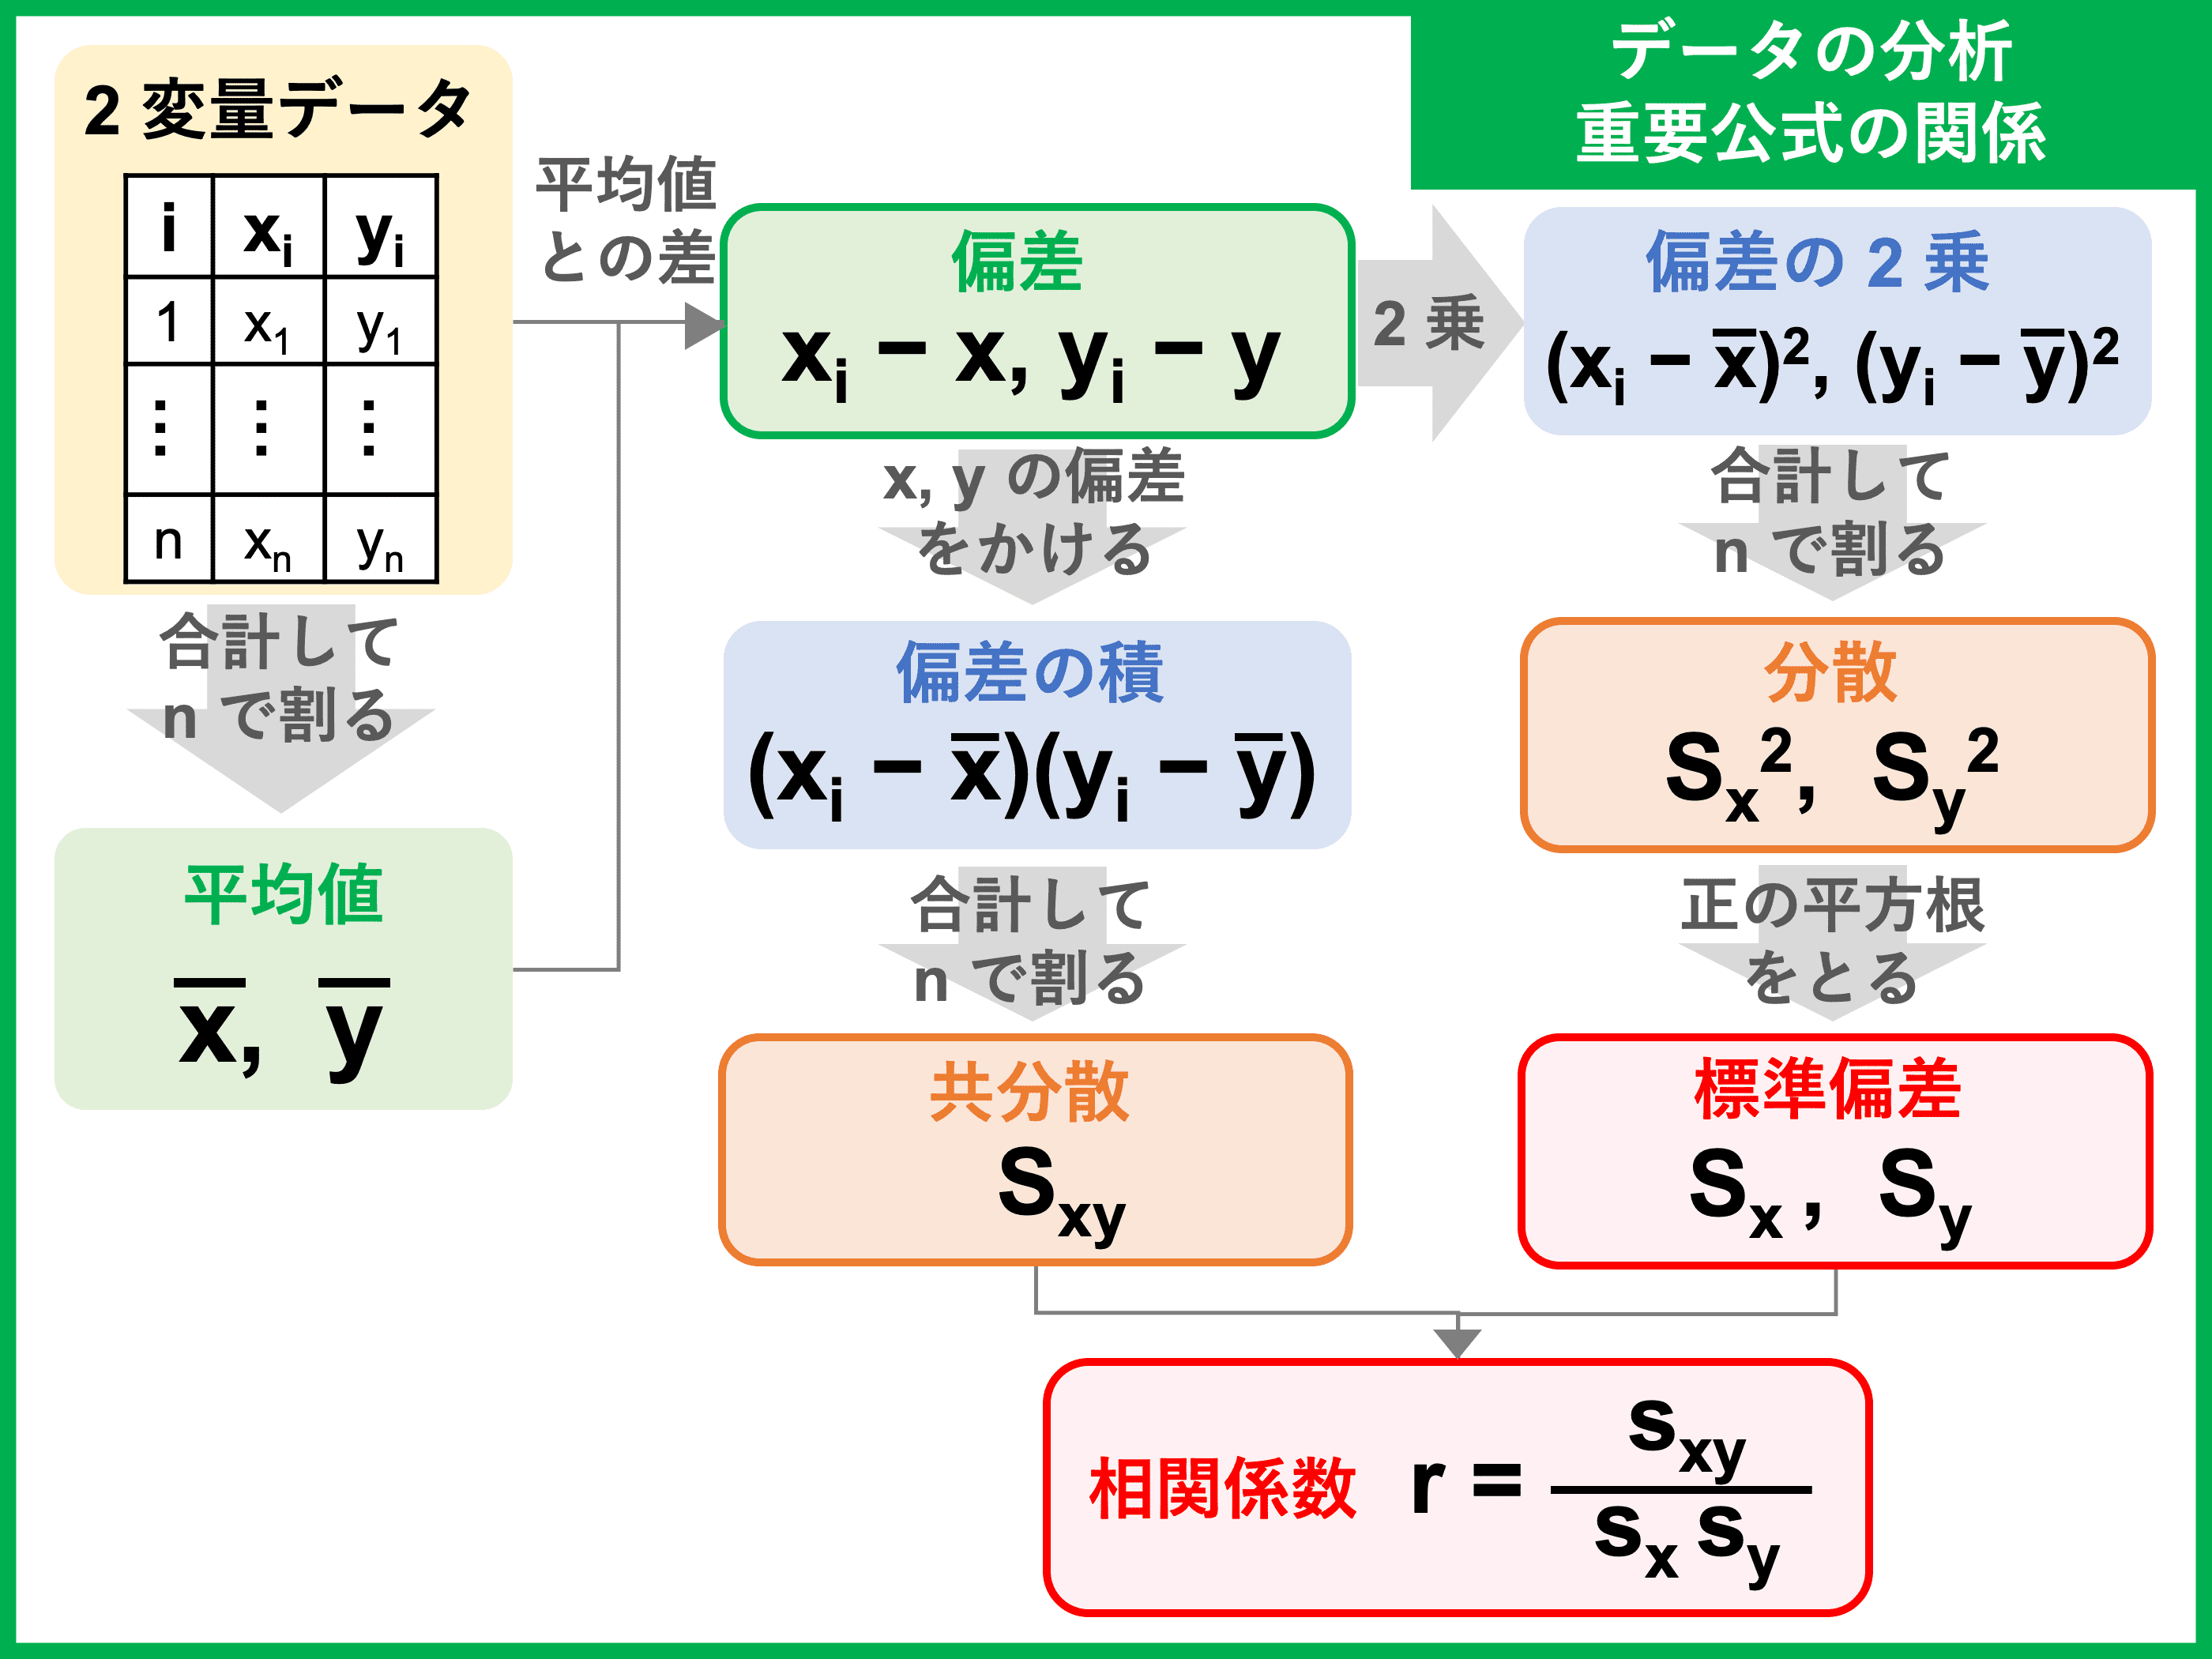
統計学データ分析の基礎において、単一のデータ群が平均値からどれくらい離れているかを表すのが分散と標準偏差です。これらは「データのバラつき指標」として広く知られています。一方、2組の異なるデータ群が「互いにどのようにバラついているか」を同時に捉えるのが共分散(Covariance)です。
たとえば、気温が上がるとアイスクリームの売上も伸びる傾向があります。このように、一方の値が増加したときにもう一方の値も増加する傾向があれば、共分散は正の値(プラス)を示します。反対に、気温が上がると暖房器具の売上が落ちるような逆の動きをする場合、共分散は負の値(マイナス)を取ります。全く無関係に動いている場合は、共分散はゼロに近づきます。
【相関係数との違い】なぜ共分散だけでは「相関の強さ」を比較できないのか
共分散を学ぶ際、最も混同しやすいのが相関係数との違いです。実務においてこの2つを明確に区別して扱わなければ、誤った経営判断を下すリスクが生じます。
共分散の最大の弱点は、扱っている数値の「単位(スケール)」に値が大きく左右される点です。例えば、同じ「身長と体重の関係」を分析する場合でも、体重を「kg」で計算したときと「g」で計算したときでは、計算される共分散の数値が1000倍も跳ね上がってしまいます。そのため、共分散の数値そのものを見て「値が大きいから強い関係がある」と判断することはできません。
この弱点を克服するために考案されたのが相関係数(ピアソンの積率相関係数)です。相関係数は、共分散をそれぞれのデータの標準偏差で割り算することで標準化し、単位の影響を完全に排除しています。結果として値は必ず「-1から+1の間」に収まり、0.7以上であれば強い正の相関といった具合に、客観的な強弱の比較が可能になります。
【図解・計算式】共分散の公式をわかりやすく解説!散布図データの見方
共分散計算式の構造は、一見複雑に見えますが分解すると極めてシンプルです。2つの変数 $X$ と $Y$ のデータ数が $n$ 個ある場合、共分散 $s_{xy}$ は以下の計算式で定義されます。
共分散の計算式:
$s_{xy} = \frac{1}{n} \sum_{i=1}^{n} (x_i - \bar{x})(y_i - \bar{y})$
ここで $(x_i - \bar{x})$ は $X$ の「平均からのズレ(偏差)」であり、$(y_i - \bar{y})$ は $Y$ の「平均からのズレ(偏差)」を表します。この公式を紐解く鍵は、偏差同士の掛け算にあります。
散布図データの見方と連動させると、直感的に理解できます。平均値を中心とする十字線を散布図上に引いたとき、右上エリア($X$ も $Y$ も平均より大きい)と左下エリア($X$ も $Y$ も平均より小さい)に点が集中すると、偏差の積はどちらもプラスになります。その結果、合計値である共分散もプラスになり、正の相関のパターンを描きます。逆に左上と右下に点が集まればマイナスになり、負の相関を示します。
【実務で即実践】Excel(COVARIANCE関数)とPythonでの共分散の求め方
実務で共分散を求める際、手計算を行う必要はありません。表計算ソフトやプログラミング言語を使えば、わずか数ステップで正確な値を抽出できます。
日常の業務分析で最も手軽なのが、Excelを活用した共分散エクセル求め方です。Excelには専用のCOVARIANCE関数が用意されており、対象範囲を指定するだけで完了します。
Excelでの計算手順:
・全数データ(母集団)を対象とする場合:=COVARIANCE.P(配列1, 配列2)
・抽出した一部データ(標本)から全体を推測する場合:=COVARIANCE.S(配列1, 配列2)
※ビジネス分析でサンプリングデータを扱う際は、通常「.S」を選択するのがセオリーです。
一方、データサイエンスや機械学習の領域ではPythonを利用します。Pandasライブラリのcov()メソッドや、NumPyのcov()関数を用いれば、大量の変数を一括で処理できます。
Pythonでの記述例:import numpy as npcov_matrix = np.cov(data_x, data_y)
実行すると出力されるのが共分散行列Pythonコードの結果であり、複数変数間の関係性がグリッド形式で一覧表示されます。
【多変量解析への応用】共分散行列の役割と機械学習・統計モデルでの活用
2つの変数だけでなく、3つ以上の膨大な指標を扱う多変量解析手法において、共分散は屋台骨の役割を果たします。各変数のバラつきと相互の関係を縦横に並べた一覧表を「分散共分散行列」と呼びます。
この行列の対角線部分には各変数の「分散」が並び、それ以外の部分には変数同士の「共分散」が配置されます。この構造は、ビッグデータを要約する主成分分析(PCA)や、金融工学における資産ポートフォリオのリスク分散最適化において、数学的な計算の基礎として欠かせない土台です。
【実務の落とし穴】外れ値の罠と因果関係の誤認を防ぐチェックポイント
共分散を実際の施策検証や効果測定で扱う際には、数字を鵜呑みにしないリテラシーが求められます。特に以下の2点には注意を払う必要があります。
第1の落とし穴は「外れ値への極端な弱さ」です。共分散は平均値からの差を二乗に近い形で掛け合わせるため、たった1つの極端な異常値(入力ミスや特殊な大口注文など)が存在するだけで、全体の数値が大きく歪みます。計算を行う前に、必ず散布図を作成して異常値がないかを目視確認するプロセスを挟んでください。
第2の落とし穴は「相関関係と因果関係の混同」です。共分散がプラスだからといって、「$X$ が原因で $Y$ が増えた」と断定はできません。別の隠れた要因(第3の変数)が両方に影響を与えている「疑似相関」の可能性を常に疑い、定性的な事実関係と照らし合わせることが不可欠です。
【データ分析の共分散】に関するよくある質問(FAQ)
Q1:共分散の値がゼロになった場合、2つのデータは完全に無関係ということですか?
A1:いいえ、直線的な関係(線形関係)がないことを意味するだけで、無関係とは限りません。例えば、U字型や山型の曲線関係(二次関数的な関係)を描くデータの場合、強い規則性があっても共分散はゼロに近くなります。必ず散布図で形状を確認してください。
Q2:Excelの「COVARIANCE.P」と「COVARIANCE.S」はどちらを使うべきですか?
A2:手元のデータが母集団そのもの(全数調査データ)なら「.P」、一部を抜き出したサンプル調査データから全体を推測するなら「.S」を使います。実務のマーケティング分析やアンケート検証では「.S」を使うのが一般的です。
Q3:共分散を先に計算するメリットは何ですか?最初から相関係数だけ出せば十分では?
A3:単に2変数の強弱を見るだけなら相関係数で十分です。しかし、主成分分析などの多変量解析を行ったり、データの物理的なバラつきの大きさそのものを保持したまま機械学習モデルに入力したりする高度な分析設計では、共分散および共分散行列が必須の計算要素となります。
まとめ:共分散の特性を理解して実務の分析精度を高める
共分散は、2つのデータ群がどのように連動しているかを可視化する統計分析の基礎パーツです。単体で関係の強弱を断定することはできませんが、符号によって増減の方向性を素早く把握できる利点があります。
実務では、まず散布図で全体の傾向と外れ値の有無を確かめ、共分散で向きを捉え、相関係数で関係の強さを数値化するという一連のステップを踏むことが鉄則です。ツールの関数を使いこなすだけでなく、各指標の強みと限界を把握した上で、説得力あるデータ分析と意思決定を推進してください。 (出典: データ の 分析 共 分散(Yahoo!ニュース))


テクノロジーやライフスタイル領域を中心に執筆活動を行っています。趣味は写真撮影と旅行です。
