Gパワー統計完全ガイド!サンプルサイズ計算と論文記載の決定版
心理学、医学、看護学、社会科学などの実証研究において、研究計画時に適切な被験者数を論理的に算出することは、いまや国際的な標準ルールとなっています。どれほど綿密に実験やアンケートを設計しても、サンプルサイズが不足していれば「統計的検出力不足」として査読で厳しく指摘され、逆に多すぎれば無駄なコストや倫理的課題を生みかねません。
そこで世界中の研究者からデファクトスタンダードとして活用されているのが、独ハインリヒ・ハイネ大学デュッセルドルフが提供する無料の統計ツール「GPower(Gパワー)」です。本稿では、研究・論文執筆で避けては通れない統計的検出力分析とサンプルサイズ計算の全体像を、具体的な操作手順や設定基準、論文への記載例まで網羅して分かりやすく解説します。
📌 【この記事の重要ポイントまとめ】
- 要点1:研究の信頼性を担保する事前分析(A priori)によるサンプルサイズ計算は、主要ジャーナル投稿や倫理審査で必須の要件。
- 要点2:GPowerを用いれば、有意水準(α)、検出力(1-β)、効果量(コーエンのdなど)を入力するだけで、t検定やANOVAに必要な正確な標本数を数秒で算出可能。
- 要点3:先行研究の有無に応じた効果量の決め方と、Methods欄にそのまま使える論文記載テンプレートを把握することで、査読対応もスムーズに進む。
【なぜ今必須なのか】研究の再現性と統計的検出力分析が求められる背景
実験や調査を行う際、「なんとなく過去の慣習で各群30人集めた」というアプローチは通用しなくなっています。背景にあるのは、学術界全体で強く叫ばれている研究の再現性の危機です。サンプル数が少なすぎると、実際には差や効果が存在するにもかかわらず、有意差が出ない「第2種の過誤(βエラー)」を引き起こす確率が高まります。
そこで不可欠となるのが、差が存在するときにそれを正しく有意であると判定できる確率を示す統計的検出力(1-β)の事前確保です。一般的な学術基準では、検出力は0.80(80%)以上、厳密な研究では0.95(95%)を目指す設計が推奨されています。
研究をスタートする前に必要な被験者数を導き出す「事前分析(A priori)」を実施し、研究計画書にその論拠を明記することが、査読をクリアするための必須条件となっています。
【導入手順】GPowerのインストール方法と日本語マニュアルの現状
GPowerは、WindowsおよびmacOS向けに完全無料で配布されています。導入の手順は極めてシンプルです。
公式サイト(Heinrich Heine University DüsseldorfのGPower配布ページ)にアクセスし、自身のOSに対応したインストーラー(.zipまたは.dmgファイル)をダウンロードします。ダウンロードしたファイルを展開し、画面の指示に従ってセットアップを進めるだけで、わずか数分で利用環境が整います。
公式インターフェースは英語のみですが、画面レイアウトは「検定ファミリの選択」「統計検定の選択」「分析タイプの選択」「パラメータ入力」の4ブロックに整理されており、直感的な操作が可能です。現在、公式のGPower日本語マニュアルは配布されていませんが、国内の大学や学会が作成した日本語ガイドラインが多数ウェブ上で公開されているため、基本用語を押さえれば言語の壁を感じることなくスムーズに扱えます。
【実践解説】Gパワーで統計的検出力とサンプルサイズを導く基本ステップ
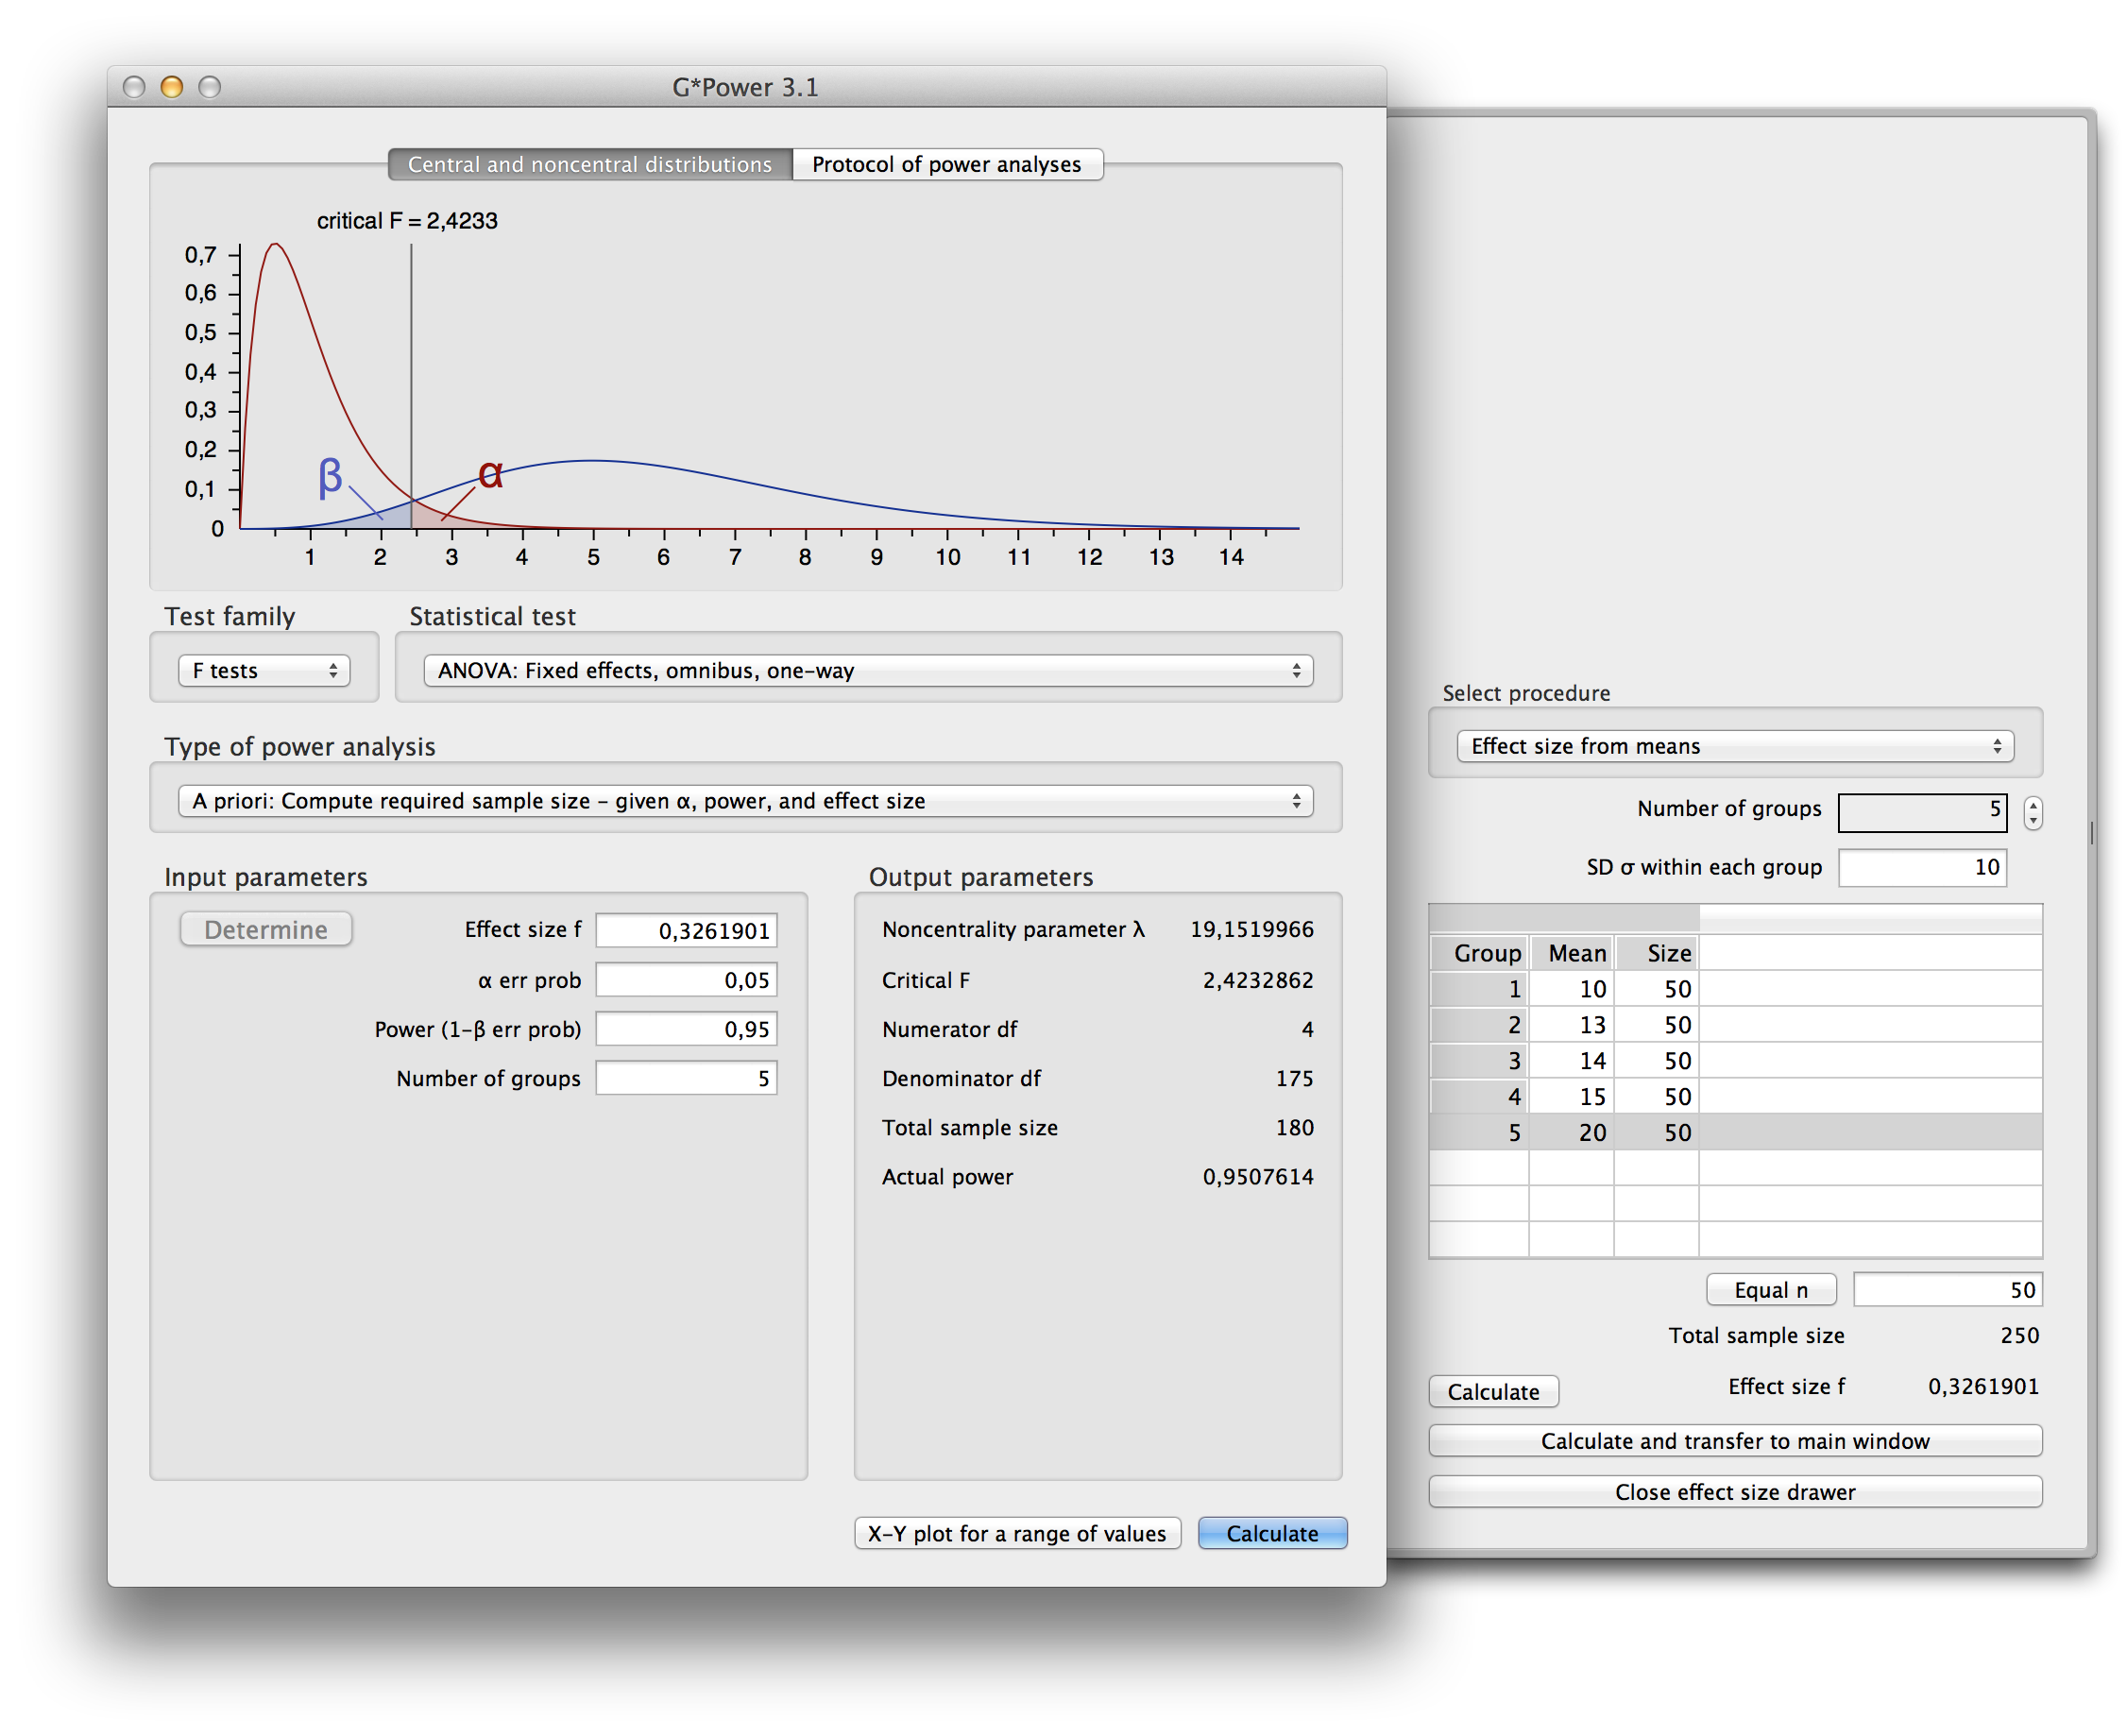
GPowerを立ち上げたら、以下の基本手順に沿ってパラメータを設定していきます。分析のタイプは、実験前に必要数を割り出す「A priori: Compute required sample size」を選択するのが鉄則です。
入力が必要となる主要パラメータは主に以下の3点に集約されます。
1. 有意水準(α err prob):第一種の過誤(差がないのに誤って差があると判定する確率)を許容する水準です。通常の研究では0.05(5%)を設定します。
2. 検出力(Power: 1-β err prob):効果を見落とさない確率です。標準的な設定値は0.80、より高精度を狙う場合は0.90〜0.95を入力します。
3. 効果量(Effect size):検証したい現象の「差や関係性の大きさ」を示す数値です。t検定ならコーエンのd、分散分析ならf、相関ならrなど、検定手法に応じた指標を投入します。
これら3つの数値を設定し、画面右下の「Calculate」をクリックすると、瞬時に必要サンプルサイズ(Total sample size)と実際の検出力が算出されます。
【検定別】t検定・分散分析(ANOVA)におけるサンプル数決定手順
研究現場で最も頻繁に用いられる検定手法ごとに、具体的な設定手順を確認します。
【2群の平均値の差:独立した2群のt検定の場合】
・Test family: t tests
・Statistical test: Means: Difference between two independent means (two groups)
・Type of power analysis: A priori
・Tail(s): 通常はTwo(両側検定)
・Effect size d: 0.50(中程度の効果)と仮定
・α err prob: 0.05
・Power (1-β): 0.80
・Allocation ratio N2/N1: 1(群ごとの比率が等しい場合)
この条件で計算すると、各群64人、合計128人が必要であると明確に算出されます。
【3群以上の比較:一元配置分散分析(One-way ANOVA)の場合】
・Test family: F tests
・Statistical test: ANOVA: Fixed effects, omnibus, one-way
・Effect size f: 0.25(中程度)
・α err prob: 0.05
・Power (1-β): 0.80
・Number of groups: 3(比較する群数)
この条件での計算結果は、合計159人(各群53人)となります。
【迷わない効果量】コーエンのdやfの目安と設定時の注意点
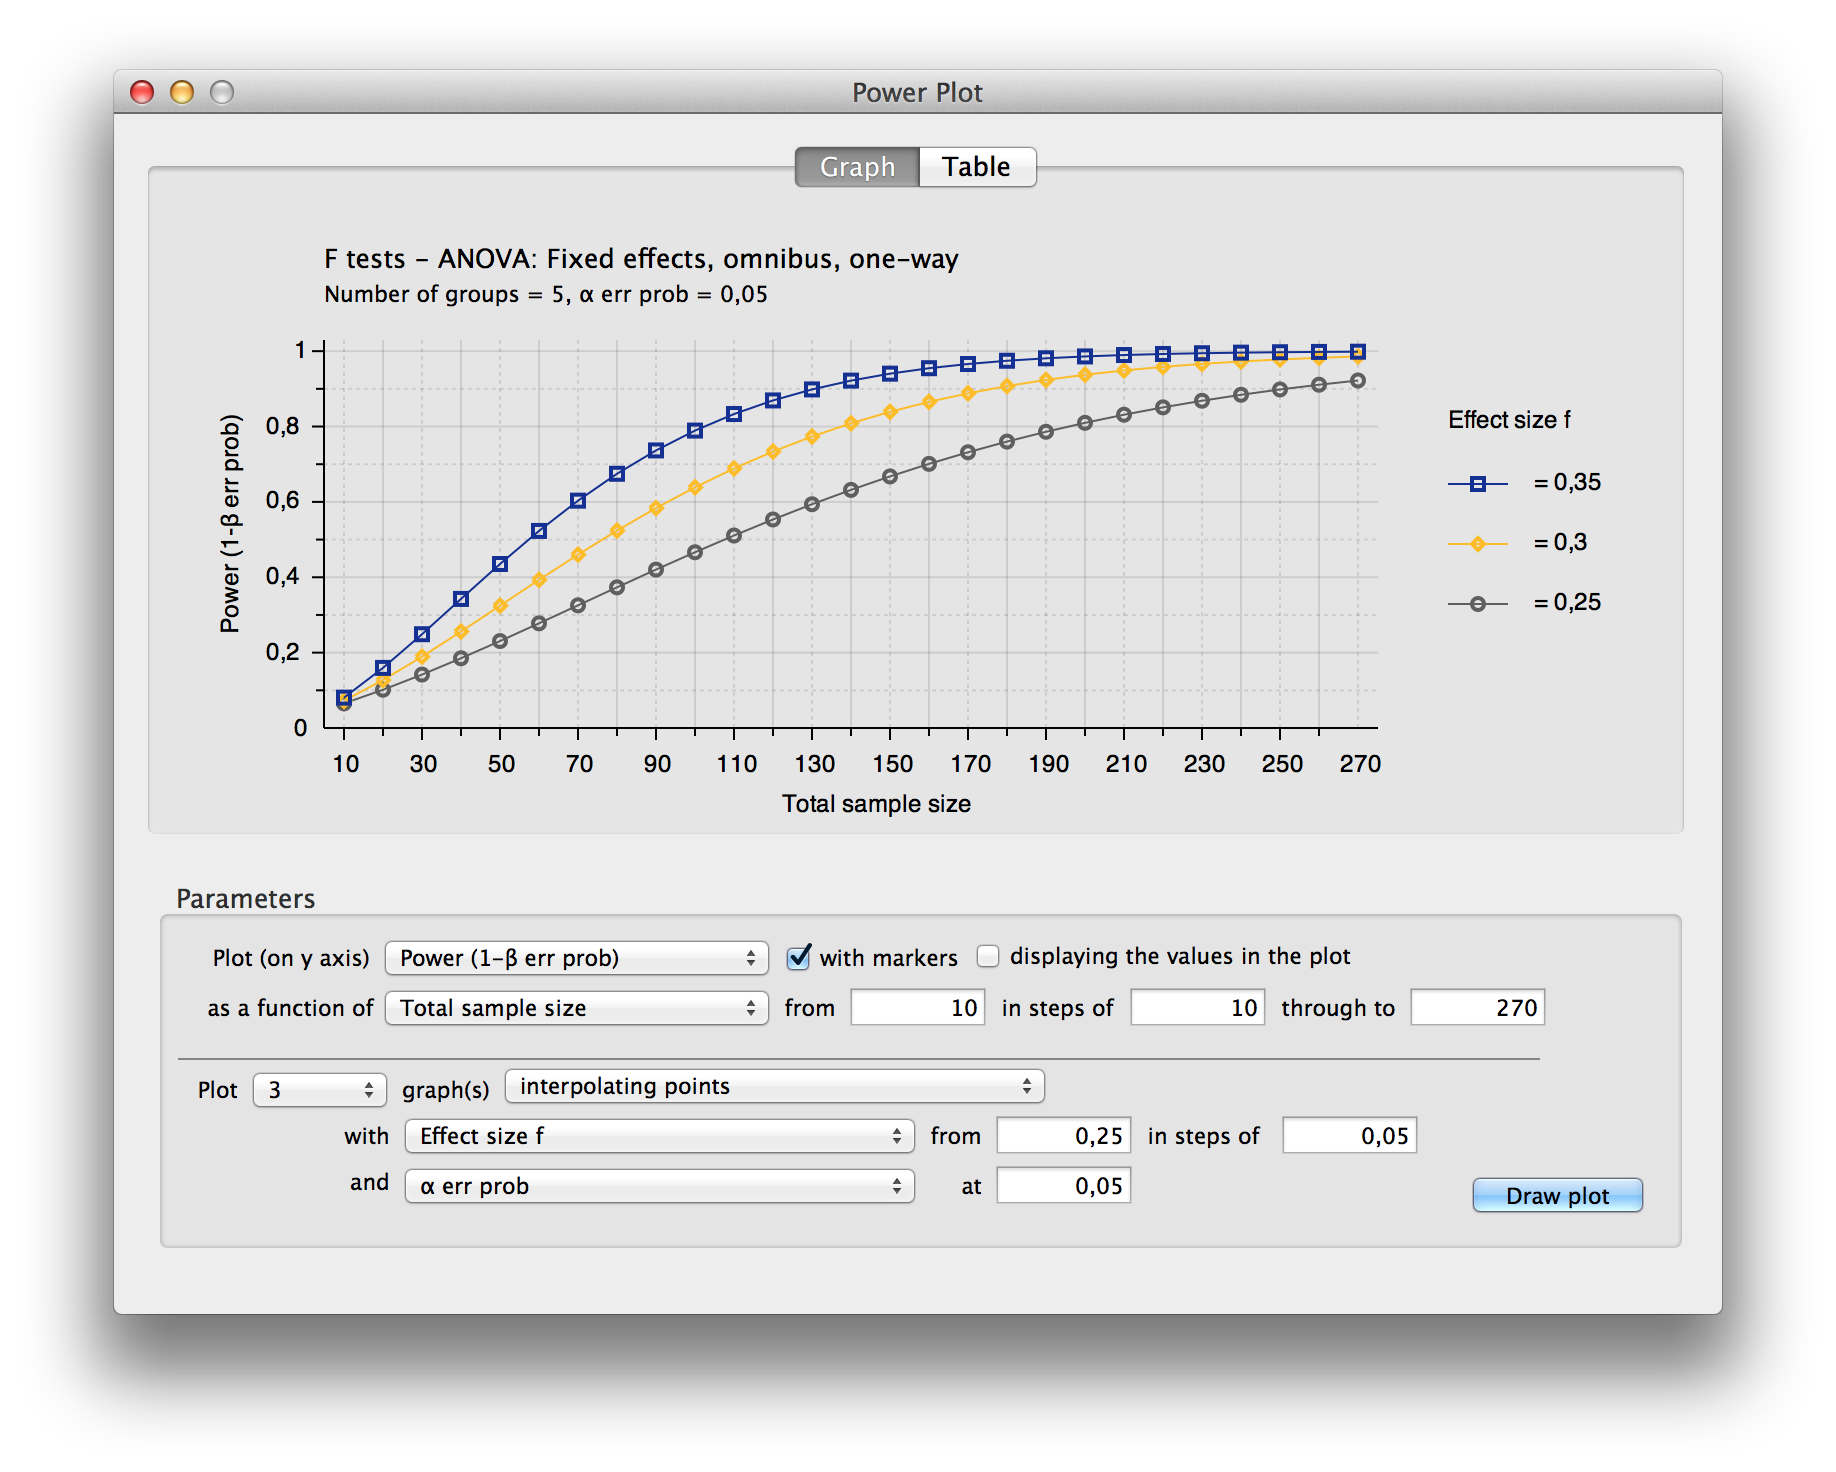
サンプルサイズ計算において最も研究者を悩ませるのが「効果量(Effect size)に何を入れるべきか」という問題です。効果量が大きければ必要サンプル数は少なくて済み、効果量が小さければ膨大なサンプル数が必要になります。
効果量の決定には、主に2つのアプローチが存在します。
最も望ましいのは、先行研究の文献値やパイロットスタディ(予備調査)のデータから実測の効果量を算出することです。GPowerの画面左側にある「Determine」ボタンを押せば、先行研究に記載されている各群の平均値と標準偏差(SD)を入力するだけで、自動的に効果量を算出してメイン画面に反映してくれます。
もし先行研究が一切ない新規分野の場合は、統計学者Jacob Cohenが提唱した一般的な基準値(Cohen's benchmarks)を適用します。
・t検定(Cohen's d):小 = 0.20、中 = 0.50、大 = 0.80
・分散分析(Cohen's f):小 = 0.10、中 = 0.25、大 = 0.40
・相関係数(r):小 = 0.10、中 = 0.30、大 = 0.50
実務上は、過大評価を避けるために「中程度(Medium)」を初期値として設計するのが安全策とされています。
【そのまま使える】論文・倫理審査申請書における統計手法の記載例
GPowerで算出した結果は、論文の「方法(Methods)」セクションや倫理審査申請書の「標本サイズの根拠」欄に正確に記述する必要があります。以下は、そのまま応用できる標準的な記載テンプレートです。
【日本語の記載例】
「本研究における必要サンプルサイズは、GPower(Version 3.1.9.7)を用いた事前検出力分析(A priori power analysis)によって決定した。独立した2群の平均値の差の検定(両側検定)を想定し、効果量d = 0.50(中程度)、有意水準α = 0.05、検出力1-β = 0.80に設定した結果、必要最小標本サイズは128名(各群64名)と算出された。脱落率10%を見込み、最終的に144名を目標サンプル数としてデータを収集した。」
【英語の記載例(英文ジャーナル用)】
"An a priori power analysis was conducted using GPower (version 3.1.9.7) to determine the required sample size for an independent samples t-test (two-tailed). With an assumed medium effect size (d = 0.50), a significance level of α = 0.05, and a statistical power of 1-β = 0.80, the minimum sample size required was determined to be 128 participants (64 per group). Considering an anticipated dropout rate of 10%, a total of 144 participants were recruited."
【Gパワー(GPower)統計】に関するよくある質問(FAQ)
Q1:データ収集が終わった後に検出力を計算する「Post hoc分析」は論文に書いてもいいですか?
A1:近年の統計学界において、事後分析(Post hoc power analysis)による検出力の報告は「得られたp値の焼き直しに過ぎず無意味」と批判されるケースが増えています。検出力分析は原則として調査・実験前の「A priori(事前分析)」で行い、計画段階の標本サイズ設計の論拠として提示することが国際的な査読標準です。
Q2:アンケート調査で回収不能や回答不備が予想される場合、どう調整すべきですか?
A2:GPowerが算出する数値は「分析に使用できる有効回答数」です。そのため、想定される脱落率(ドロップアウト率)を事前に加味して配布数を逆算します。例えば必要数が100人で、脱落率を20%と見込む場合は「100 ÷ (1 - 0.20) = 125人」を配布目標数に設定します。
Q3:対応のあるt検定(Paired t-test)と対応のないt検定でサンプルサイズは大きく変わりますか?
A3:大きく変わります。同一被験者の前後比較などを行う「対応のあるt検定」は、被験者間変動が相殺されるため、対応のないt検定と比べて格段に少ないサンプルサイズ(同じ中程度の効果量d=0.50、α=0.05、1-β=0.80の場合で合計34人)で十分な検出力を得ることができます。
【総括】妥当性の高いデータ収集で研究の質を劇的に高める
適切なサンプルサイズの算出は、単なる形式的な手続きではなく、無駄なデータ収集コストを削ぎ落とし、得られた研究成果の学術的信頼性を担保するための根幹です。
GPowerを正しく活用すれば、検定力分析に要する時間を大幅に削減しつつ、査読者や審査員を納得させる強固な方法論を構築できます。研究計画の初期段階からG*Powerを味方につけ、再現性と説得力に満ちた研究論文の完成を目指しましょう。 (出典: g パワー 統計(Yahoo!ニュース))

情報を整理して届けることが得意なWebディレクター。ユーザー視点に立った記事作成を目指しています。
