ポアソン分布とは?稀な現象の確率・計算式や二項分布との違いを徹底解説
データ分析やAI活用がビジネスの現場で当たり前となった現在、顧客の来店予測からサーバーの障害対策、工場の品質管理に至るまで、あらゆる場面で「確率統計」の知識が求められています。その中でも、実務で頻繁に登場しながら「概念が掴みにくい」とつまずきやすいのがポアソン分布です。
「1時間に数回しか起きない問い合わせの件数」や「滅多に発生しないシステムの不具合」など、ランダムかつ低頻度に発生する事象をモデル化する際、ポアソン分布は極めて強力な武器になります。基礎知識から実務での計算手法、混同しやすい他の確率分布との違いまで、要点を分かりやすく解き明かしていきます。
📌 【この記事の重要ポイントまとめ】
- 要点1:ポアソン分布は「一定の期間や空間において、めったに起きない事象が発生する回数」を表す離散確率分布。
- 要点2:期待値(平均)と分散がどちらも同じパラメータ「λ(ラムダ)」になるという際立った数学的特徴を持つ。
- 要点3:二項分布の極限(発生確率が極めて低いケース)から導出され、事象の間隔を測る「指数分布」とは表裏一体の関係にある。
【直感的に理解】ポアソン分布とは?「めったに起きない稀な現象」を予測する統計の基本
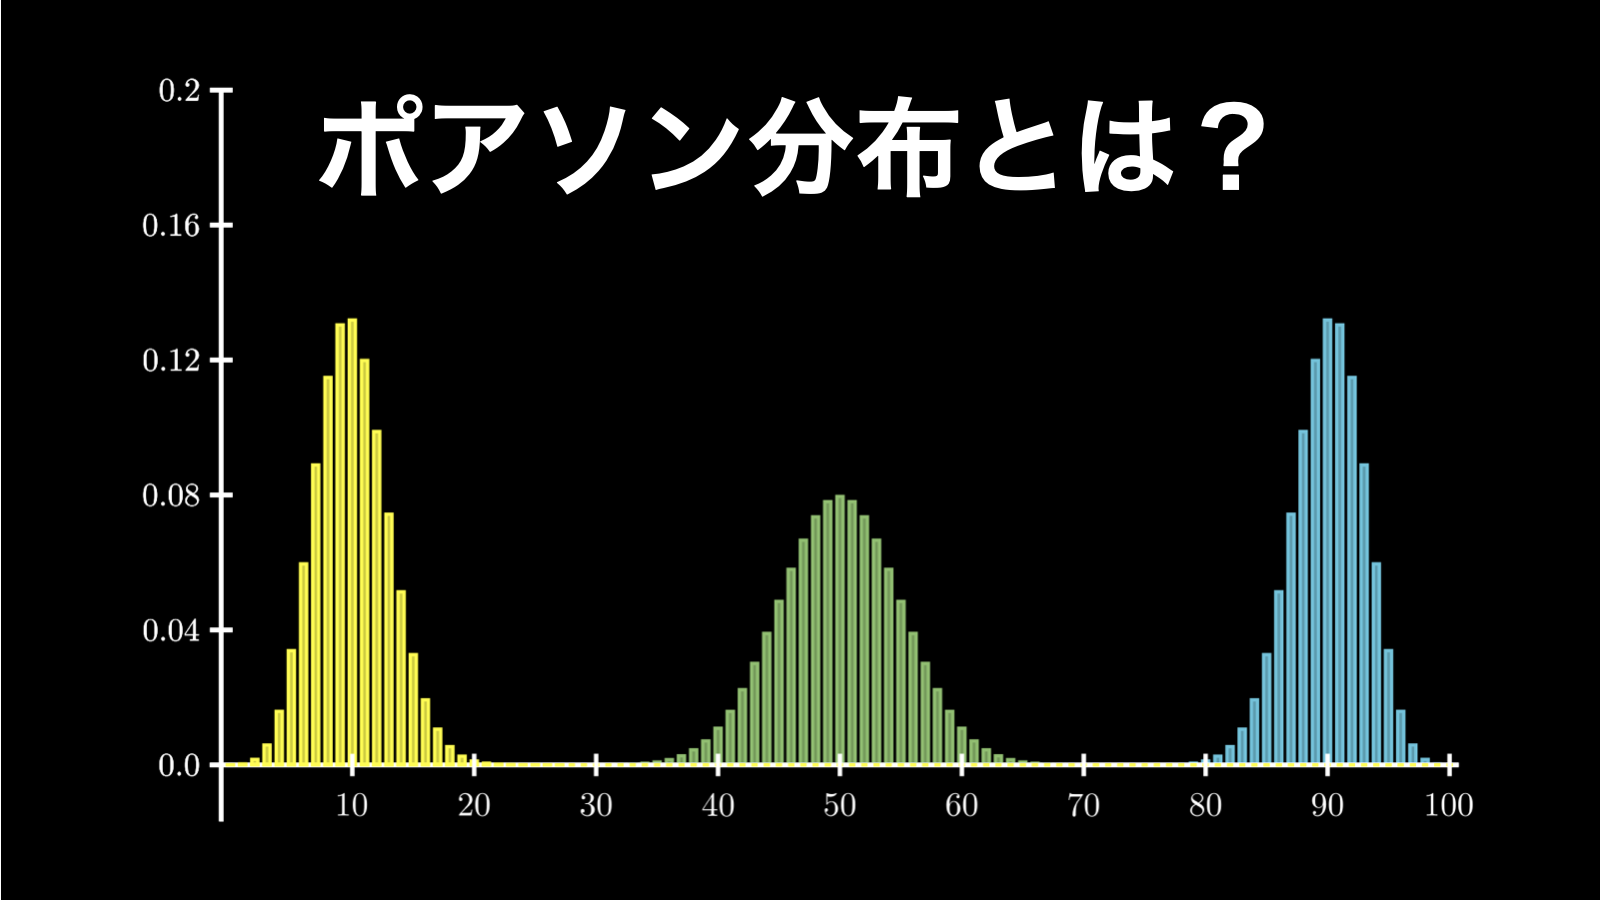
統計学におけるポアソン分布(Poisson distribution)とは、「ある一定の時間や特定の空間の中で、滅多に起きない現象が何回発生するか」を表す確率分布です。19世紀のフランスの数学者シメオン・ドニ・ポアソンが提唱し、歴史的には「プロイセン軍で兵士が馬に蹴られて死亡した事故件数」の分析に使われたエピソードが広く知られています。
統計学を学び始めた初心者がまず押さえるべきは、ポアソン分布がサイコロの目やコインの表裏のように飛び飛びの値を数える「離散型確率分布」であるという点です。連続的なデータ(身長や気温など)を扱う正規分布とは異なり、事象の発生件数(0回、1回、2回……)という整数値を扱います。数学的には連続型の指標に「確率密度関数」を用いますが、離散型であるポアソン分布の場合は正確には「確率質量関数」と呼び、特定回数 $k$ が生じる確率そのものを算出します。
ポアソン分布が成立するためには、事象が完全にランダムで互いに影響を与えず、同時発生しないという「ポアソン過程」の前提が必要です。この前提が満たされるとき、平均して平均 $\lambda$ 回起きる現象が、指定した区間でちょうど $k$ 回起きる確率は以下の公式で定義されます。
$$P(X = k) = \frac{\lambda^k e^{-\lambda}}{k!}$$
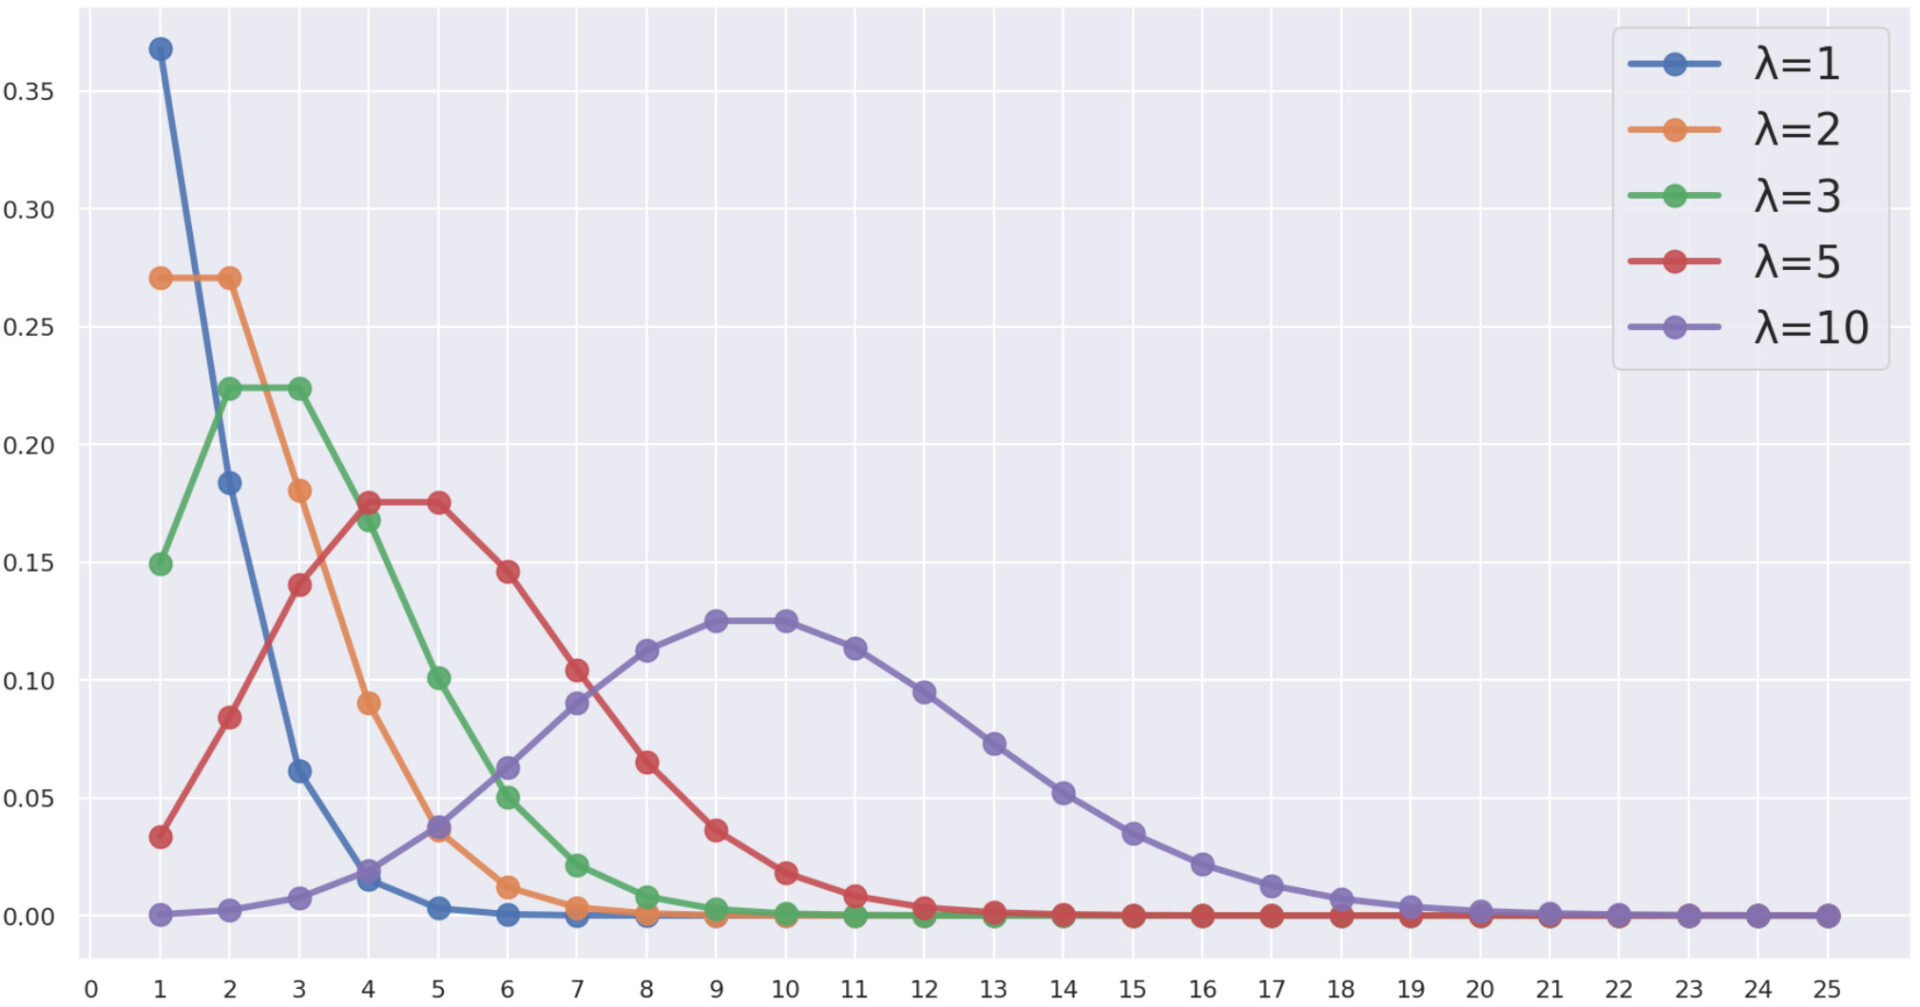
ここで $e$ はネイピア数(自然対数の底:約2.71828)、$k!$ は $k$ の階乗を表します。一見すると複雑に見える数式ですが、必要なパラメータは「平均発生回数($\lambda$:ラムダ)」ただ1つという、非常にシンプルで実用性の高い構造になっています。
日常からビジネスまで!身近なポアソン分布の具体例
ポアソン分布は机上の空論ではなく、私たちの日常生活やビジネスの現場で日々発生する現象の予測に深く根ざしています。代表的な具体例を整理すると、その応用範囲の広さが分かります。
代表的な活用シーンには以下のようなケースが挙げられます。
- Webサービスのアクセス制御:1分間あたりに特定のAPIエンドポイントやサーバーへ届くアクセススパイクの検知。
- コールセンターの受電予測:平日午前の1時間あたりにかかってくる問い合わせ電話の件数と、必要なオペレーター人数の最適化。
- 製造業の品質管理:製品ラインで製造される精密機器1万個あたりに含まれる初期不良品の個数。
- 都市インフラ・防災:特定の交差点で1年間に発生する重大事故の件数や、年間を通じた大規模地震の発生確率。
- 医療・保険分野:特定地域における稀少疾患の新規発症者数や、加入者からの保険金請求件数の見積もり。
例えば、「平均して1時間に3件の問い合わせが来るコールセンター」があったとします。このとき「次の1時間に1件も電話が鳴らない確率」や「5件以上殺到して回線がパンクする確率」を割り出し、適切な待機スタッフ数を割り出すといったオペレーション最適化に直結しています。
二項分布・指数分布との違いは?混同しやすい確率分布の関係性を整理
ポアソン分布を深く理解する上で避けて通れないのが、近接する他の確率分布との関係性です。特に二項分布と指数分布の2つは混同されやすいため、その決定的な違いを明確にしておきましょう。
二項分布との決定的な違いと「ポアソンの小数の法則」
二項分布は「成功確率 $p$ の試行を $n$ 回行ったときに、何回成功するか」を表す分布です。コインを10回投げて表が出る回数などを計算する際に使います。
二項分布とポアソン分布の違いは「試行回数 $n$ と発生確率 $p$ の規模」にあります。試行回数 $n$ が無限に大きく($n \to \infty$)、1回あたりの発生確率 $p$ が極めてゼロに近い微小な値($p \to 0$)でありながら、その積である平均発生数 $\lambda = np$ が一定に保たれる極限を考えると、二項分布の公式は数学的にポアソン分布の公式へと完全に一致します。これを統計学では「ポアソンの小数の法則」と呼びます。
日常の例で言えば、「無数のアクセス試行がある中で、ごく稀に発生するクリック」をモデル化する場合、二項分布で計算するのは膨大な計算負荷がかかりますが、ポアソン分布を使えば $\lambda$ だけで瞬時に高精度な近似計算が可能になります。
指数分布との違い|「回数」か「時間の間隔」か
もう一つの重要テーマが指数分布との関係です。両者の違いは、着目している対象が「発生回数」なのか「発生するまでの時間」なのかという1点に集約されます。
一定期間内にイベントが起きる「回数」を数えるのがポアソン分布であるのに対し、あるイベントが発生してから「次に同じイベントが発生するまでの待ち時間(間隔)」を表すのが指数分布です。つまり、事象の発生がポアソン過程に従っている場合、その発生件数はポアソン分布に従い、発生間隔は自動的に指数分布に従うという「表裏一体」の関係が成り立っています。
公式の仕組みと計算方法|パラメータ「λ(ラムダ)」と期待値・分散の一致
ポアソン分布が数学的に極めて美しいとされる最大の理由は、「期待値(平均)と分散が完全に一致し、どちらも $\lambda$ になる」という際立った特徴にあります。
一般的な確率分布では、平均値とデータのばらつき度合いを示す分散は別々の値を取ります。しかしポアソン分布では、平均して発生する回数 $\lambda$ が決まれば、そのばらつき(分散)も自動的に $\lambda$ に決定されます。したがって、標準偏差は $\sqrt{\lambda}$ で表されます。
実例として、「1日に平均2件($\lambda = 2$)の障害が発生する社内システム」を想定し、手計算の流れを確認してみましょう。ある特定の日に障害が「ちょうど1件($k = 1$)」発生する確率は次のように計算します。
$$P(X = 1) = \frac{2^1 \cdot e^{-2}}{1!} = \frac{2 \cdot 0.1353}{1} \approx 0.2706 \quad (27.06\%)$$
同様に「障害が全く起きない日($k = 0$)」の確率は、
$$P(X = 0) = \frac{2^0 \cdot e^{-2}}{0!} = \frac{1 \cdot 0.1353}{1} \approx 0.1353 \quad (13.53\%)$$
となります。このように、平均値 $\lambda$ さえ把握していれば、特殊なツールを使わなくてもネイピア数の値を用いて容易に確率を算出できます。
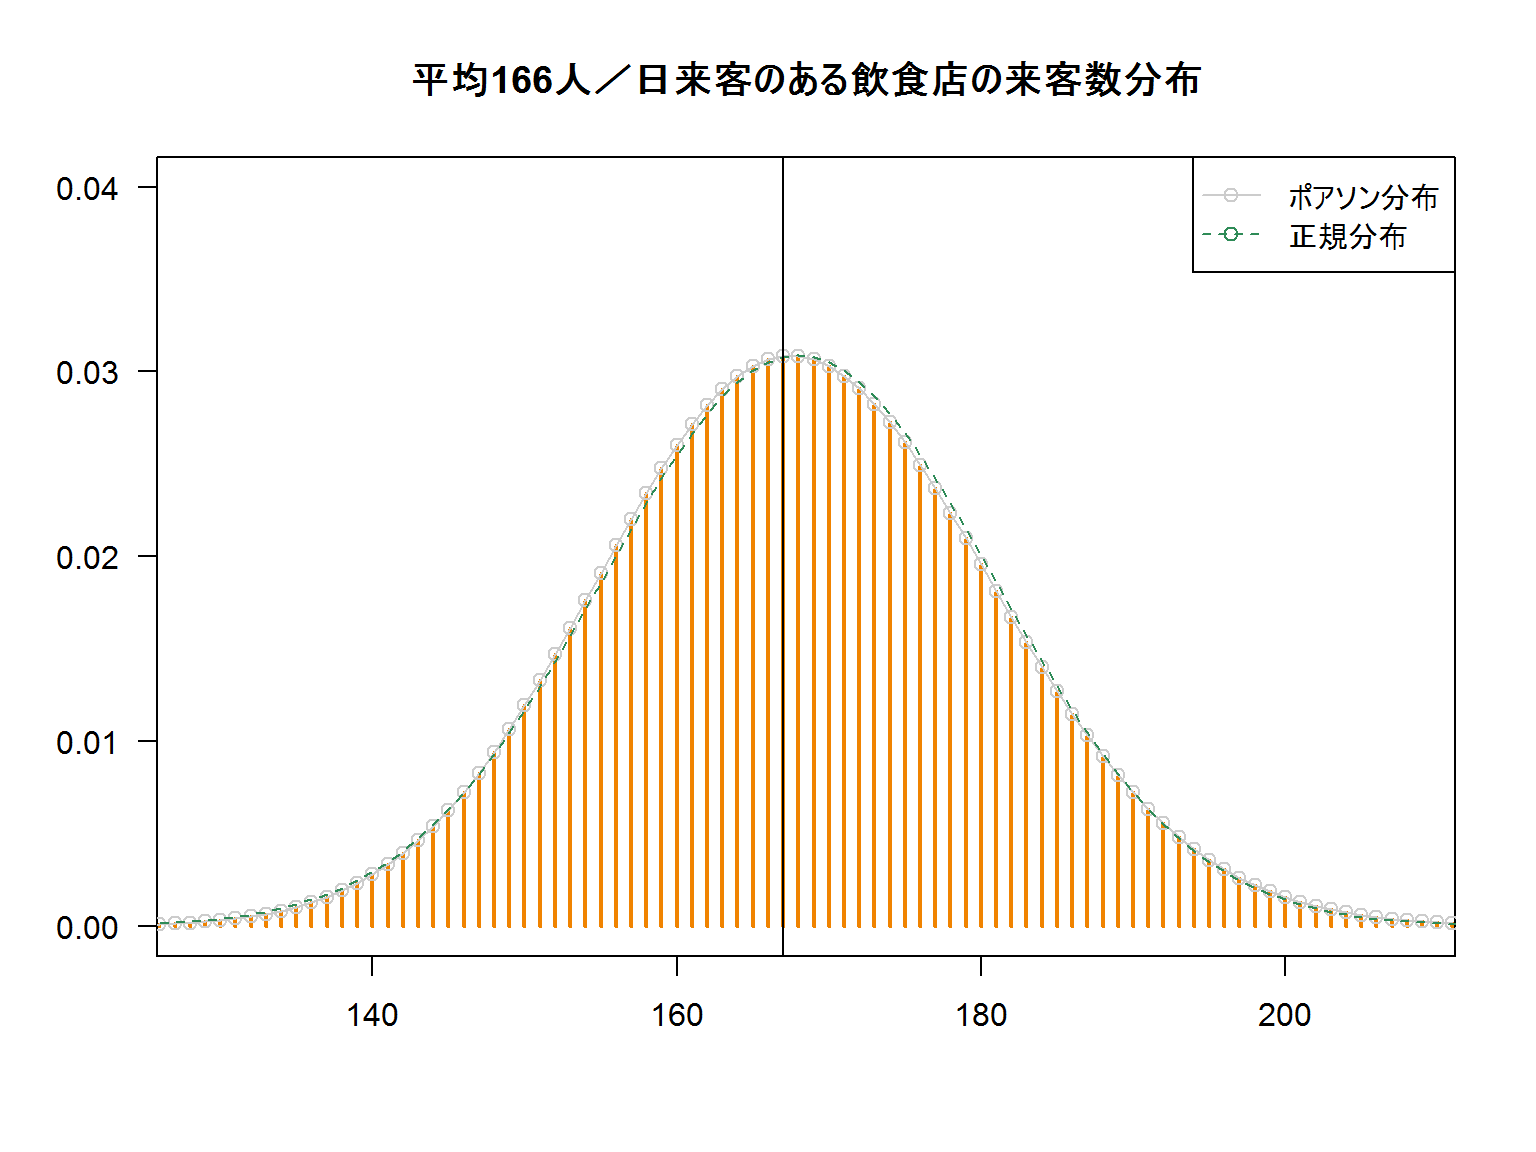
また、パラメータ $\lambda$ の値が大きくなる(一般に $\lambda \ge 20$ 程度)と、ポアソン分布のグラフは左右対称の釣鐘型へと近づいていき、正規分布 $N(\lambda, \lambda)$ へと近似できるという性質(正規分布近似)も実務上極めて有用です。
実務ですぐ使える!Excel(エクセル)でのポアソン分布の計算手順
実務の現場でポアソン分布を用いる際、数式を手計算する必要はありません。Microsoft Excelをはじめとするスプレッドシートツールには、標準で専用の関数が組み込まれています。
Excelでポアソン確率を計算するには、POISSON.DIST 関数を使用します。
=POISSON.DIST(イベント数k, 平均値λ, 関数形式)
引数の設定ルールは極めてシンプルです。
- イベント数(x):発生回数 $k$ を指定(例:3件なら
3)。 - 平均(mean):平均発生件数 $\lambda$ を指定(例:平均2件なら
2)。 - 関数形式(cumulative):
FALSE(または0):ちょうどその回数が発生する「個別確率」を算出。TRUE(または1):0回からその回数以下までに収まる「累積確率」を算出。
例えば、「1時間あたりの平均来店客数が5人の店舗で、次の1時間にちょうど3人来店する確率」を求める場合は =POISSON.DIST(3, 5, FALSE) と入力します(結果:約14.04%)。
一方、「次の1時間の来店客数が最大でも3人以下にとどまる確率」を求めたい場合は =POISSON.DIST(3, 5, TRUE) を指定します(結果:約26.50%)。キャパシティ設計やリスクヘッジを行う際は、この累積確率の指定が威力を発揮します。
【ポアソン分布とは】に関するよくある質問(FAQ)
Q1:ポアソン分布と正規分布はどう使い分ければよいですか?
A1:扱うデータの性質と発生頻度で判断します。「不良品の個数」や「事故件数」のような離散値(カウントデータ)で、かつ発生が稀な場合はポアソン分布が適しています。一方、身長や重量のように連続する数値データや、ポアソン分布でも平均発生回数 $\lambda$ が十分に大きい(20以上など)場合は正規分布で扱います。
Q2:なぜポアソン分布では期待値と分散が同じ値になるのですか?
A2:二項分布の極限として導出される数学的構造に由来します。二項分布の期待値は $np$、分散は $np(1-p)$ です。ポアソン分布の前提である「$p$ が極めて0に近い($p \to 0$)」という条件を適用すると、$(1-p)$ はほぼ1となるため、分散 $np(1-p)$ は期待値 $np$ と等しい $\lambda$ に収束するためです。
Q3:ポアソン分布が適用できないケースにはどのようなものがありますか?
A3:事象同士が互いに影響を与え合っている(独立性がない)ケースです。例えば「感染症のアウトブレイク(1人が発症すると周囲に連鎖する)」や「金融市場での連続暴落」のように、1回の発生が次の発生確率を高める事象にはポアソン分布をそのまま適用できません。その場合は負の二項分布や自己励起型の点過程モデル(ホークス過程など)が用いられます。
まとめ:データ活用時代に必須のポアソン分布の要点
ポアソン分布は、「滅多に起きない事象の発生件数」という、一見すると予測が不可能なランダム現象を精緻に捉えるための強力な統計フレームワークです。平均値 $\lambda$ だけで分布全体の形状が決まり、期待値と分散が一致するというシンプルさは、実務におけるモデル構築でも大きな強みとなります。
二項分布との極限関係や指数分布との表裏一体の構造を正しく整理しておけば、業務でのデータ分析やキャパシティ計画、リスク管理の精度は格段に向上します。まずは身の回りのカウントデータとExcel関数を用いて、ポアソン分布の実践的な挙動を確かめてみることをおすすめします。 (出典: ポアソン 分布 とは(Yahoo!ニュース))
情報を整理して届けることが得意なWebディレクター。ユーザー視点に立った記事作成を目指しています。
